OpenAI đã dành ngày 29 tháng 9 năm 2026 tại DevDay để phát hành GPT-6.1 Sol, một mô hình tầm trung nhằm khắc phục vấn đề chi phí của GPT-6 Astra. Một ngày sau, Google công bố Gemini 4 Argon, và bản phát hành sẽ đến với các đội an ninh mạng trước khi đến tay nhà phát triển.
Koray Kavukcuoglu, Phó Chủ tịch cấp cao của Google DeepMind, giới thiệu Argon vào ngày 30 tháng 9 năm 2026 như mô hình tiên phong của Google cho công việc dài hạn: kỹ nghệ phần mềm trong thế giới thực, công việc tri thức pháp lý và tài chính, và phòng thủ an ninh mạng.
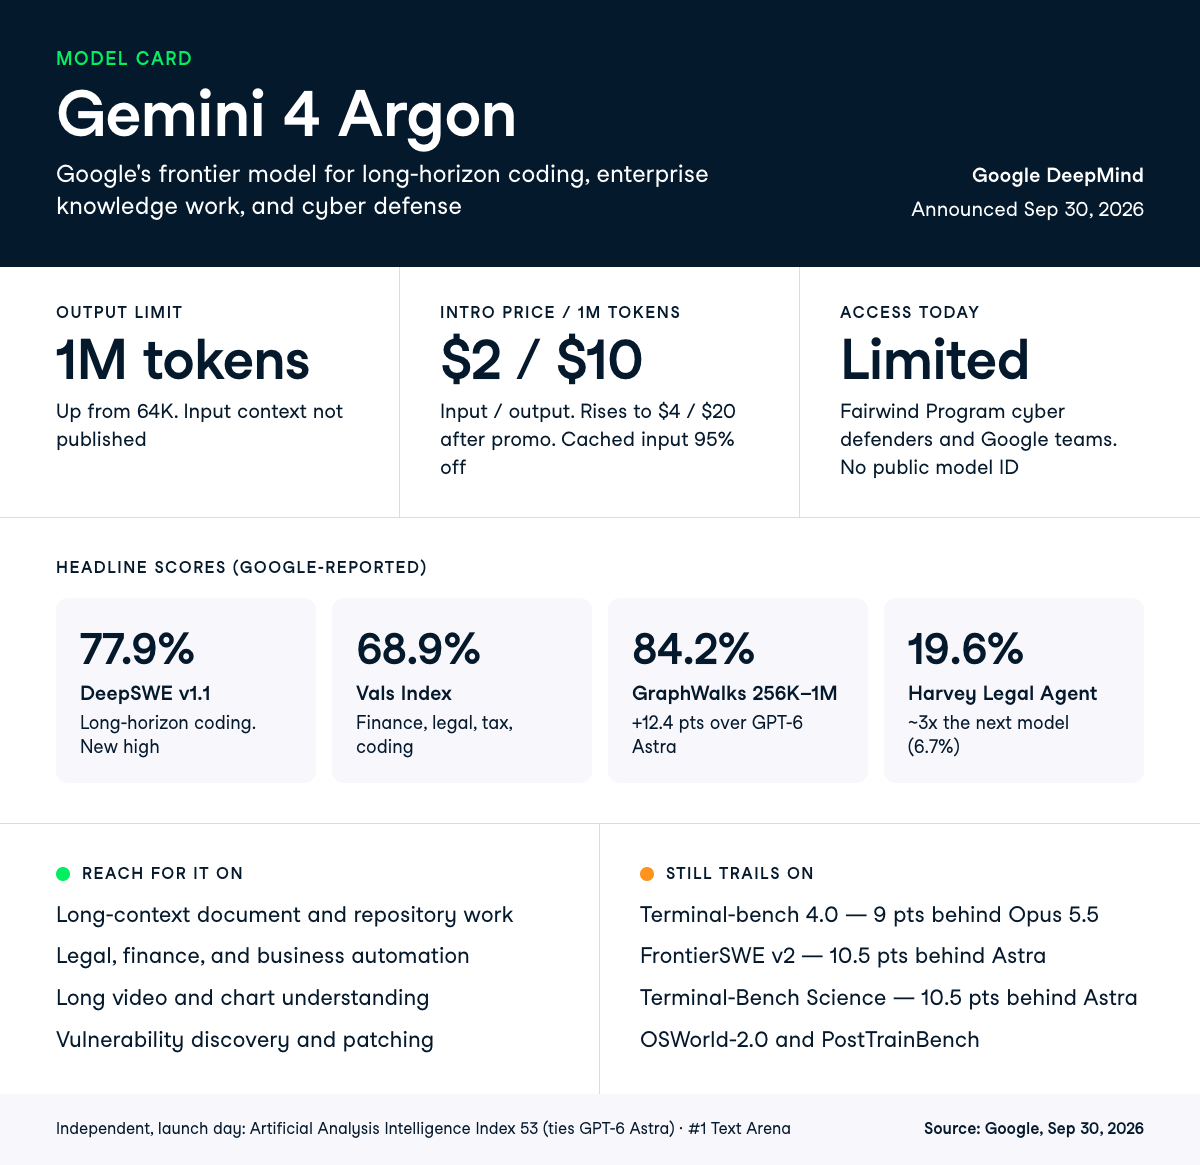
Thay đổi kỹ thuật nổi bật là giới hạn token đầu ra, tăng vọt lên 1 triệu token từ mức 64K. Mô hình thiết lập kỷ lục mới trên DeepSWE v1.1 với 77,9%, và đang được triển khai trước thông qua Chương trình Fairwind tới một nhóm các chuyên gia phòng thủ an ninh mạng đáng tin cậy.
Để so sánh với đối thủ, xem các hướng dẫn của chúng tôi về GPT-6.1 Sol và Claude Sonnet 5.5.
Tóm tắt nhanh
- Argon là mô hình tiên phong mới của Google, và sẽ đến với các chuyên gia phòng thủ an ninh mạng đáng tin cậy qua Chương trình Fairwind trước khi xuất hiện trên API công khai.
- Thay đổi cấu trúc quan trọng là độ dài đầu ra, không phải ngữ cảnh đầu vào: Argon có thể viết một quãng suy luận dài gấp 16 lần so với trần 64K trước đây.
- Mô hình dẫn đầu mọi điểm chuẩn về công việc tri thức cấp doanh nghiệp mà Google công bố, và khoảng cách ở mảng pháp lý là rất lớn.
- GPT-6 Astra vẫn thắng ở các tác vụ khoa học dựa trên terminal và FrontierSWE v2, và Claude Opus 5.5 vẫn thắng Terminal-bench 4.0.
- Mức giá mở đầu $2 cho mỗi triệu token đầu vào rẻ hơn Astra 5 lần, nhưng sẽ tăng gấp đôi khi hết khuyến mãi.
- Chưa có gì để chuyển sang ngay bây giờ. Chưa có model ID công khai, chưa có niêm yết trên đám mây, và chưa có bên thứ ba tái lập bất kỳ điểm số nào.
Gemini 4 Argon là gì?
Gemini 4 Argon là mô hình tiên phong mới của Google, định vị ở đỉnh gia đình Gemini phía trên dòng Gemini 3.8 đã phát hành trong tháng 9 năm 2026.
Google mô tả mô hình được xây dựng để duy trì suy luận sâu xuyên suốt các quy trình phức tạp, dài hạn, với ba miền mục tiêu được nêu tên: kỹ nghệ phần mềm, công việc tri thức doanh nghiệp như pháp lý và tài chính, và phòng thủ an ninh mạng.
Thay đổi thế hệ rõ ràng nhất là cách Google mở rộng giới hạn token đầu ra lên 1 triệu token, từ mức 64K, nghĩa là Argon có thể tạo ra hàng trăm nghìn token trong một lần suy luận thay vì bị buộc dừng và nhắc lại.
Các tính năng chính của Gemini 4 Argon
Bộ tính năng của Argon xoay quanh các tác vụ kéo dài hàng giờ thay vì vài giây, thể hiện ở ngân sách đầu ra, công việc của agent, và bộ công cụ an ninh mạng. Dưới đây là bốn năng lực thay đổi những gì bạn có thể thực sự xây dựng.
Viết 1 triệu token trong một lần
Argon có thể tạo tối đa 1 triệu token đầu ra trong một lần sinh, so với 64K ở thế hệ trước.
Lập luận của Google là khoảng không này thay đổi chất lượng suy luận chứ không chỉ độ dài: khi mô hình có thể suy nghĩ và tạo sinh xuyên suốt hàng trăm nghìn token trong một quãng suy luận, nó giải quyết vấn đề khó hơn mà không cần chắp vá và mất trạng thái như quy trình chia khúc.
Để so sánh, GPT-6 Astra giới hạn đầu ra ở 128K token với cửa sổ ngữ cảnh 1,05 triệu.
Nếu bạn từng thấy một agent “lạc đề” giữa chừng khi refactor lớn vì chạm trần đầu ra và phải khởi động lại, thì đây chính là ràng buộc đang được gỡ bỏ.
Lưu ý dở là vấn đề tính phí. Các lần sinh dài với mức $10 cho mỗi triệu token đầu ra sẽ cộng dồn rất nhanh, và Google chưa công bố liệu token suy luận có bị tính theo mức đầu ra hay không.
Chạy di trú codebase đầu-cuối
Các agent Argon đã và đang di trú codebase C và C++ sang Rust bên trong Google, mở rộng từ hàng chục nghìn dòng trong các thư viện lõi như re2 và libgav1 lên hơn 800 nghìn dòng cho nhân Zircon của hệ điều hành Fuchsia.
Đó là loại công việc thường ngốn vài quý công sức kỹ sư, và Google nói những bản viết lại này đi qua kiểm định tự động và thủ công, kiểm thử mô phỏng, và đánh giá trước khi đưa vào sản xuất.
Kết quả của libgav1 là thứ tôi cứ quay lại xem mãi.
Các agent Argon đã lấy một bản port Rust sẵn có của bộ giải mã video mã nguồn mở của Google và thay thế 32 nghìn dòng mã SIMD viết tay bằng cách chạy nhiều vòng thử nghiệm có hướng dẫn từ profiling và nghiên cứu đầu ra của trình biên dịch cho đến khi trình biên dịch tự động vector hóa Rust an toàn.
Kết quả là một bộ giải mã an toàn bộ nhớ chạy nhanh hơn 2,7 lần so với bản port Rust với chất lượng video đầu ra giống hệt.
Kết quả triển khai nội bộ tại Google
Có hai con số nội bộ đáng rút ra vì chúng gần nhất với kết quả thế giới thực trong toàn bộ thông báo.
- Google cho biết một nhóm agent Argon đã phân tích telemetry profiling trên toàn cụm máy và tự động áp dụng tối ưu hóa bộ nhớ trên các trung tâm dữ liệu, giải phóng hơn 300 TiB bộ nhớ sau khi triển khai, với ước tính tổng tiết kiệm từ 500 TiB đến 1 PiB.
- Con số thứ hai đến từ nghiên cứu điện toán lượng tử, nơi Argon giúp tối ưu tài nguyên không-thời gian (số qubit nhân với số cổng) của các thủ tục con gây nghẽn cổ chai. Trong một trường hợp, nó vượt mốc tham chiếu đã công bố 40% chỉ trong vài phút.
Cả hai kết quả đều chưa có xác minh bên ngoài, nhưng đủ cụ thể để kiểm chứng sau này.
Xử lý tài chính, pháp lý, và tự động hóa doanh nghiệp với ngữ cảnh trực quan
Argon nhắm thẳng vào công việc tri thức nơi bằng chứng tồn tại trong biểu đồ, hồ sơ, và video thay vì một prompt văn bản sạch.
Google dẫn ra các ca sử dụng hạng nhất như phân tích biểu đồ chuyên nghiệp, trích xuất chi tiết từ video dài, và thực thi hành động xuyên suốt chuỗi tài liệu, và Argon đạt 91,7% trên LVBench cho hiểu video dài.
Phiên bản thực tế của điều này, chẳng hạn, là một tác vụ nghiên cứu tài chính nhiều bước nơi mô hình đọc deck, đối chiếu một bảng, rồi thực thi trong một hệ thống kinh doanh.
Argon xếp hạng nhất trên AutomationBench của Zapier với 51,3%, đo lường năng lực thực thi đầu-cuối trên các chức năng kinh doanh cốt lõi thay vì câu trả lời một lượt.
Tìm và vá lỗ hổng khi bỏ hàng rào bảo vệ
Đây là điểm khác thường nhất trong bản phát hành.
Đối với những người phòng thủ đáng tin trong Chương trình Fairwind và các đội nội bộ của Google, Google phát hành Argon không có hàng rào bảo vệ an ninh mạng, để các đội này có đầy đủ năng lực cận-tấn công của mô hình phục vụ công tác phòng thủ: tự động tìm, xác thực và vá lỗ hổng phần mềm.
Wiz đã chạy Argon trong sáng kiến Scan for Good, vốn khắc phục miễn phí các rủi ro phơi lộ cao trong hạ tầng công cộng.
Trong một màn trình diễn sớm, Argon tìm ra một lỗ hổng nghiêm trọng làm lộ thông tin cá nhân nhạy cảm trên phần mềm y tế được bệnh viện trên toàn thế giới sử dụng, mà Google cho biết các mô hình tiên phong trước đó đã bỏ lỡ.
Cùng với đó, Google nói Argon là mô hình chống chịu tốt nhất của họ trước prompt injection gián tiếp và dẫn đầu điểm chuẩn IPI của Gray Swan, và các bộ giám sát chuỗi suy nghĩ và hành động sẽ dừng thực thi khi mô hình lệch khỏi ý định người dùng.
Google cũng lưu ý họ cố ý không đưa các phát hiện từ giám sát vào dữ liệu huấn luyện để suy luận của Argon không bị “định hình” nhằm né tránh giám sát, điều mà tôi ước nhiều phòng thí nghiệm khác cũng công bố.
Gemini 4 Argon thể hiện thế nào trên các điểm chuẩn?
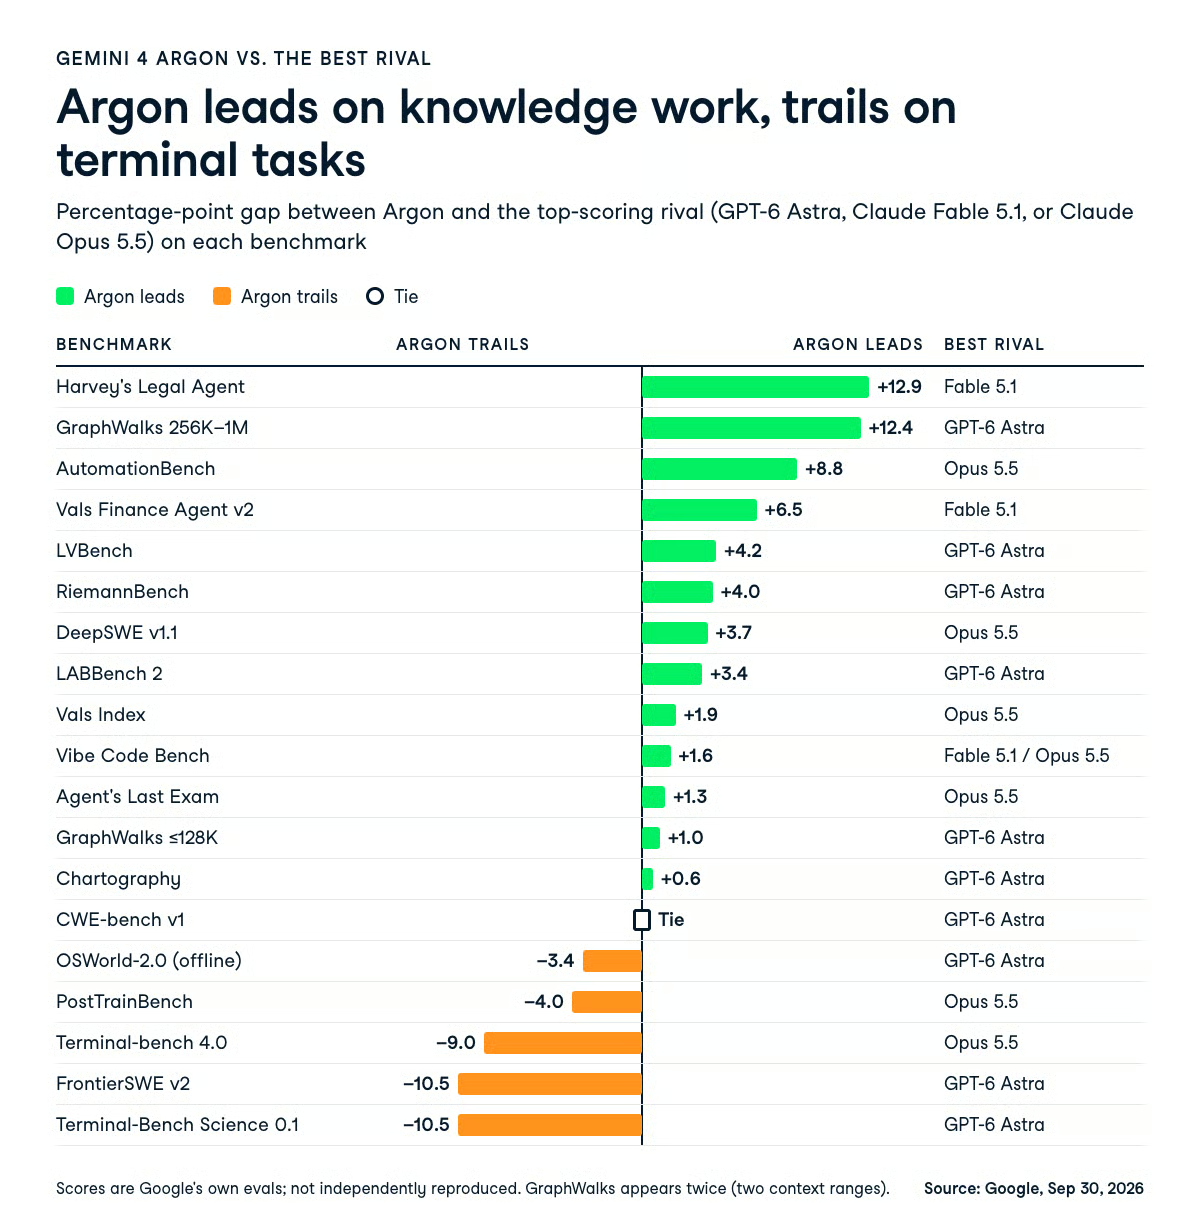
Argon dẫn đầu 13 trong số 19 điểm chuẩn mà Google công bố khi so với GPT-6 Astra, Claude Fable 5.1, và Claude Opus 5.5, và các chiến thắng tập trung ở công việc tri thức, ngữ cảnh dài, và khắc phục lỗ hổng.
Các điểm thua tụ lại ở khoa học điều khiển qua terminal và một trong hai bộ điểm chuẩn kỹ nghệ phần mềm, đây là một mẫu hình thú vị hơn là “thắng sạch”.
Công việc tri thức doanh nghiệp
Đây là thế mạnh nhất của Argon và là lý do Google đặt khuôn khổ ra mắt xoay quanh pháp lý và tài chính.
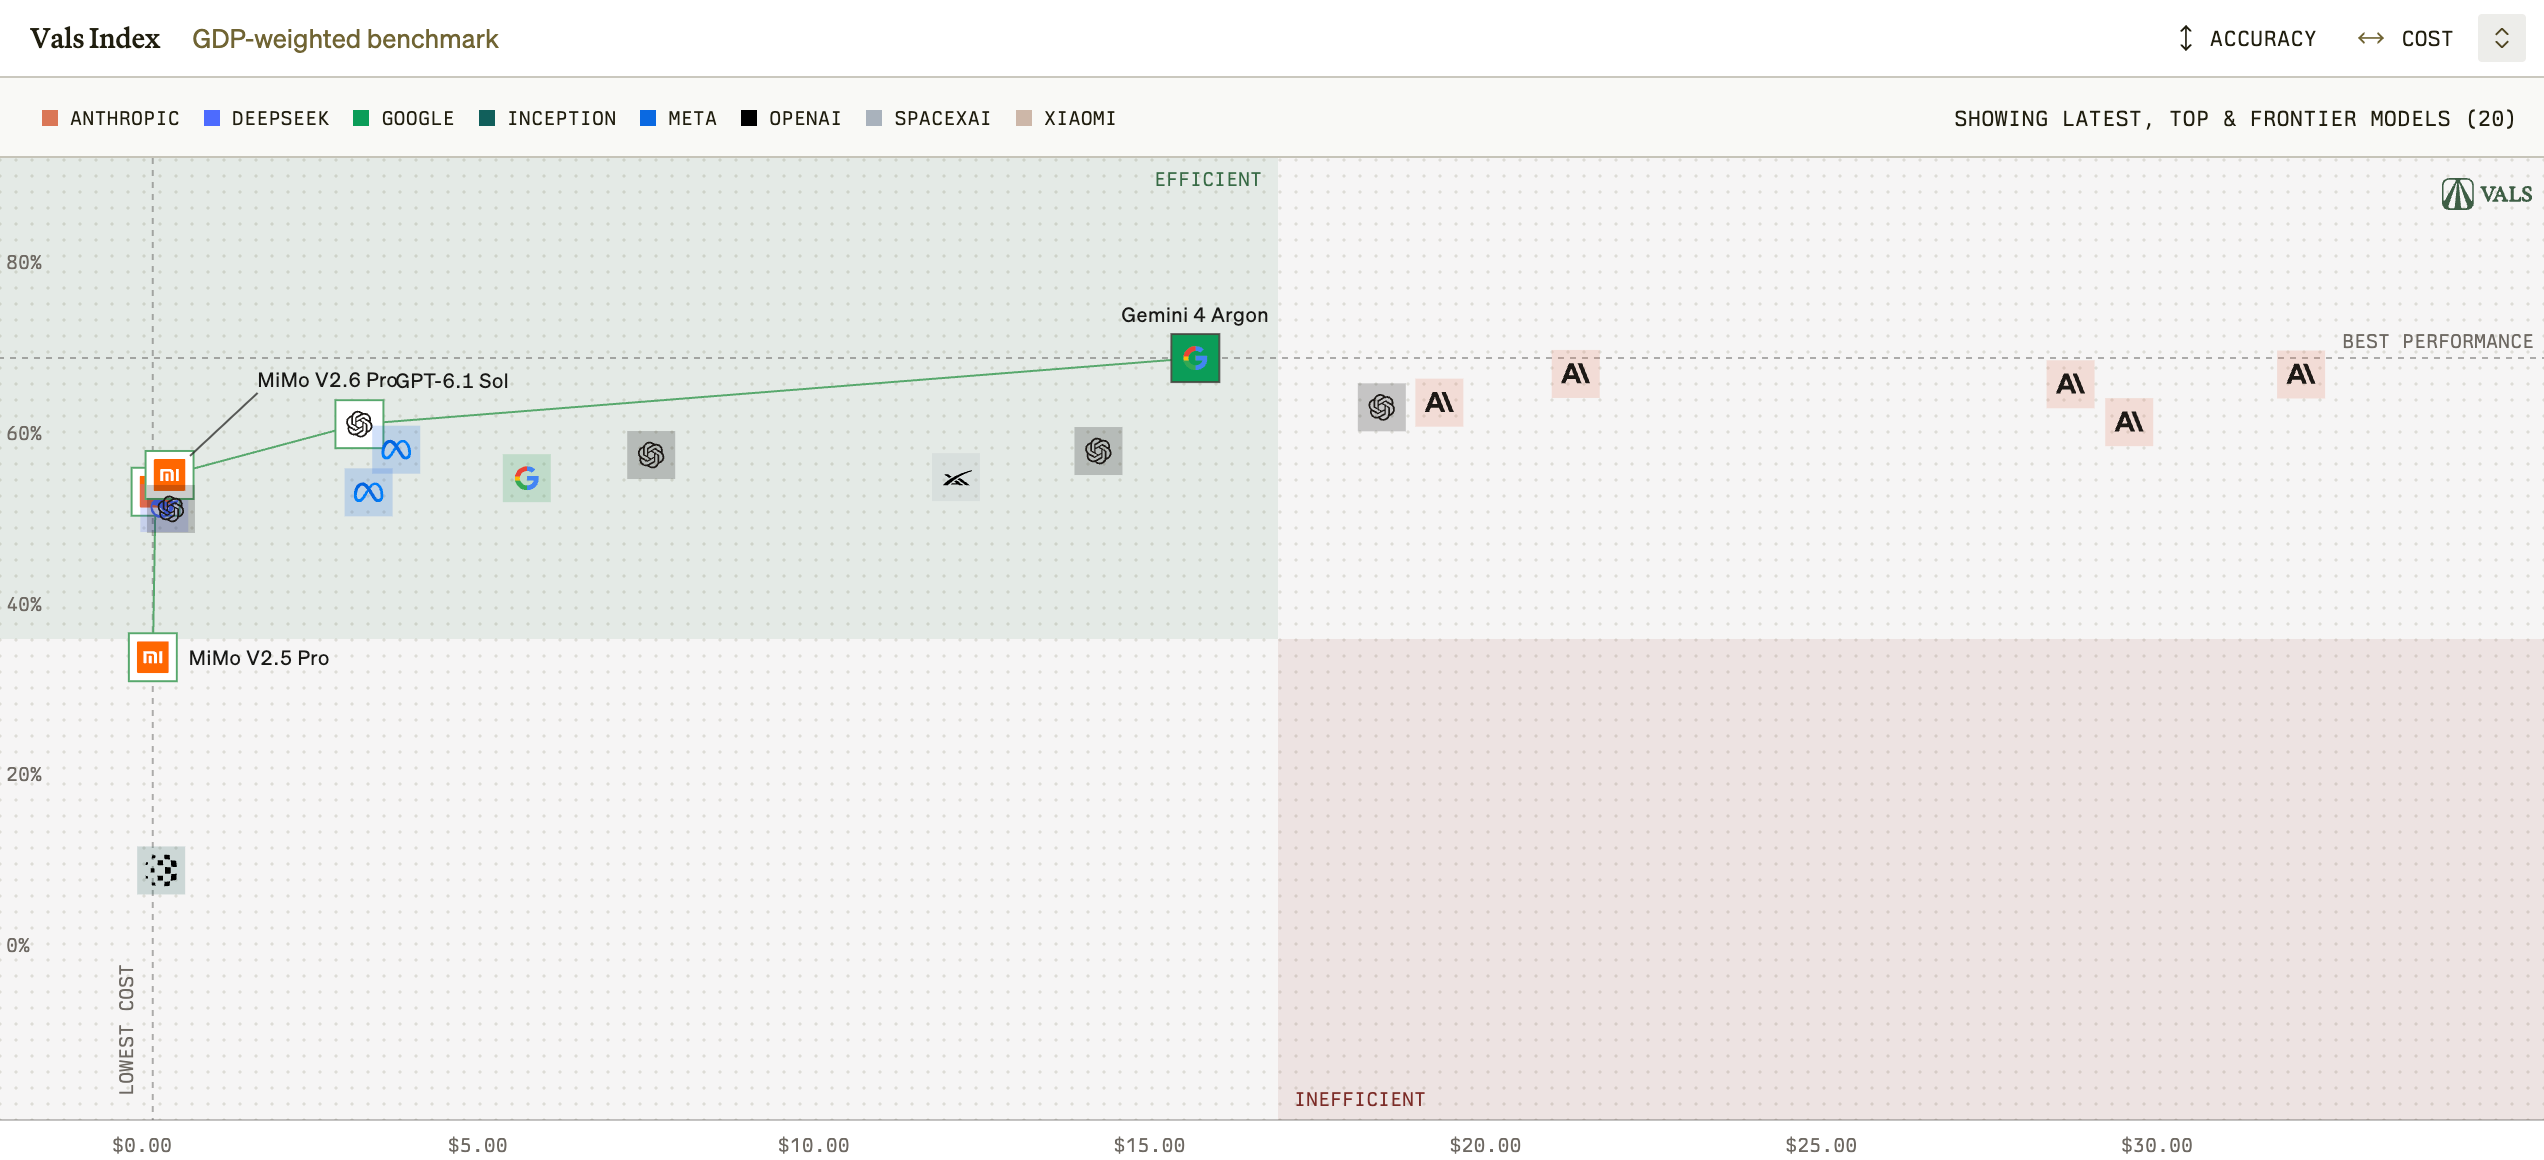
Trên Vals Index, vốn cân trọng tài chính, lập trình, pháp lý, và thuế theo mức đóng góp GDP Hoa Kỳ, Argon đạt 68,9% so với 67,0% của Claude Opus 5.5, 65,8% của Claude Fable 5.1, và 63,1% của GPT-6 Astra.
Khoảng cách nới rộng ở các đánh giá agent theo miền cụ thể.
Argon đạt 65,4% trên Vals Finance Agent v2 (nghiên cứu tài chính nhiều bước) so với 58,9% cho Fable 5.1 và 53,5% cho Astra, và 51,3% trên AutomationBench so với 42,5% cho Opus 5.5 và 31,4% cho Fable 5.1.
Harvey's Legal Agent Benchmark là ngoại lệ.
Argon đạt 19,6% so với 6,7% cho Fable 5.1, 5,4% cho Astra, và 3,8% cho Opus 5.5. Mọi mô hình đều trượt phần lớn điểm chuẩn này, nên hãy xem đây là tín hiệu tương đối về nghiên cứu và soạn thảo pháp lý hơn là một mô hình bạn có thể giao hợp đồng mà không giám sát.
Lập trình theo kiểu agent
Argon dẫn đầu DeepSWE v1.1 với 77,9%, vượt Claude Opus 5.5 ở mức 74,2%, GPT-6 Astra ở mức 74,1%, và Claude Fable 5.1 ở mức 67,4%.
DeepSWE đo lường kỹ nghệ phần mềm dài hạn trên các kho mã thực, nên ưu tiên những mô hình có thể giữ kế hoạch xuyên suốt nhiều lần chỉnh sửa hơn là chỉ tạo một bản diff tốt.
Kết quả đó sẽ có ý nghĩa khác khi bạn tính giá.
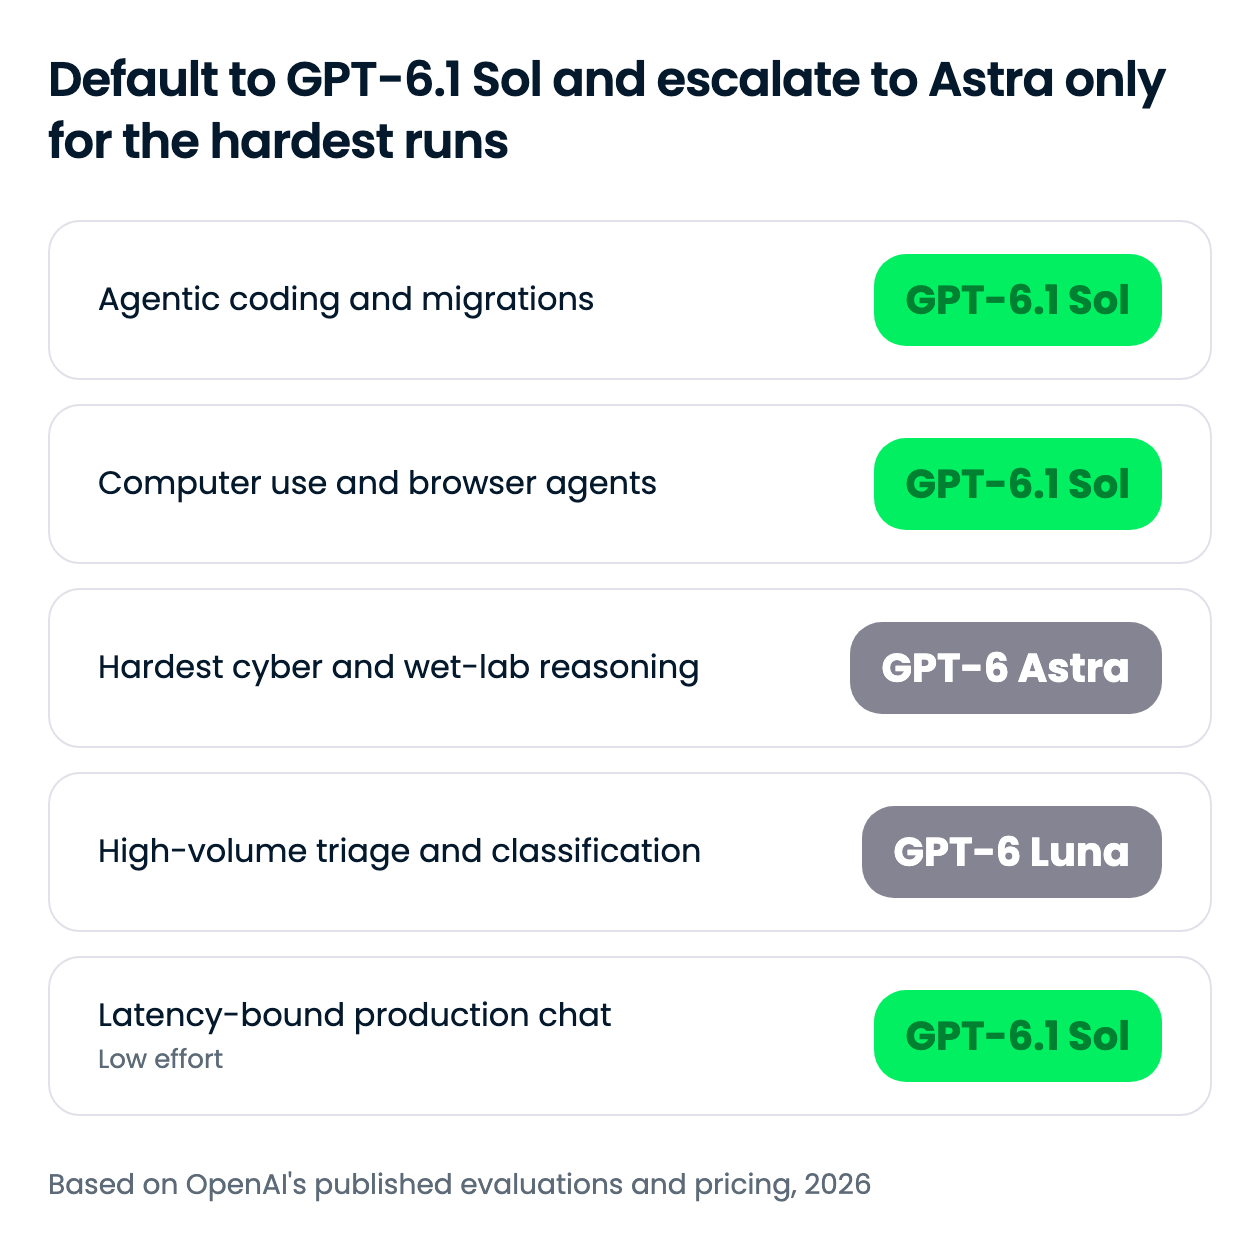
Trong bài viết về GPT-6.1 Sol, chúng tôi ghi nhận Sol sánh ngang Astra trên DeepSWE v1.1 với chi phí khoảng một phần năm của Astra, ở mức $2 đầu vào và $10 đầu ra mỗi triệu token.
Mức ra mắt của Argon y hệt $2/$10, và nó vượt Astra ở DeepSWE thêm 3,8 điểm.
Vibe Code Bench cũng thuộc về Argon, ở mức 91,9% so với 90,3% của cả hai mô hình Claude và 89,6% của Astra, dù chênh 1,6 điểm trên bốn mô hình tiên phong gần như là nhiễu.
Ngữ cảnh dài và hiểu đa phương thức
Khoảng cách ngữ cảnh dài là rộng nhất trong toàn bộ bảng.
Trên GraphWalks BFS F1 từ 256K đến 1M token, Argon đạt 84,2% so với 71,8% của Astra, 66,8% của Opus 5.5, và 65,0% của Fable 5.1.
Ở mức tối đa 128K, mọi mô hình đều cao, nhưng Argon vẫn dẫn với 99,7%.
GraphWalks yêu cầu mô hình duyệt qua một đồ thị được mô tả trong prompt, nên độ chính xác suy giảm mạnh khi truy xuất trên cửa sổ rất dài trở nên kém tin cậy.
Khoảng cách 12,4 điểm so với Astra ở đầu 1M là kiểu biên độ quyết định việc bạn có thể nạp cả một kho mã hay trọn bộ biên bản lấy lời khai vào một lần gọi hay không.
Ở công việc đa phương thức, Argon dẫn LVBench ở mức 91,7% (so với 87,5% của Astra và 79,7% của Fable 5.1) và Chartography ở mức 71,6%, nhỉnh hơn 71,0% của Astra.
Để so sánh, bài viết về Claude Sonnet 5.5 của chúng tôi ghi nhận 61,6% trên Chartography cho Sonnet 5.5 và 64,4% cho Opus 5.5.
Khắc phục sự cố an ninh mạng
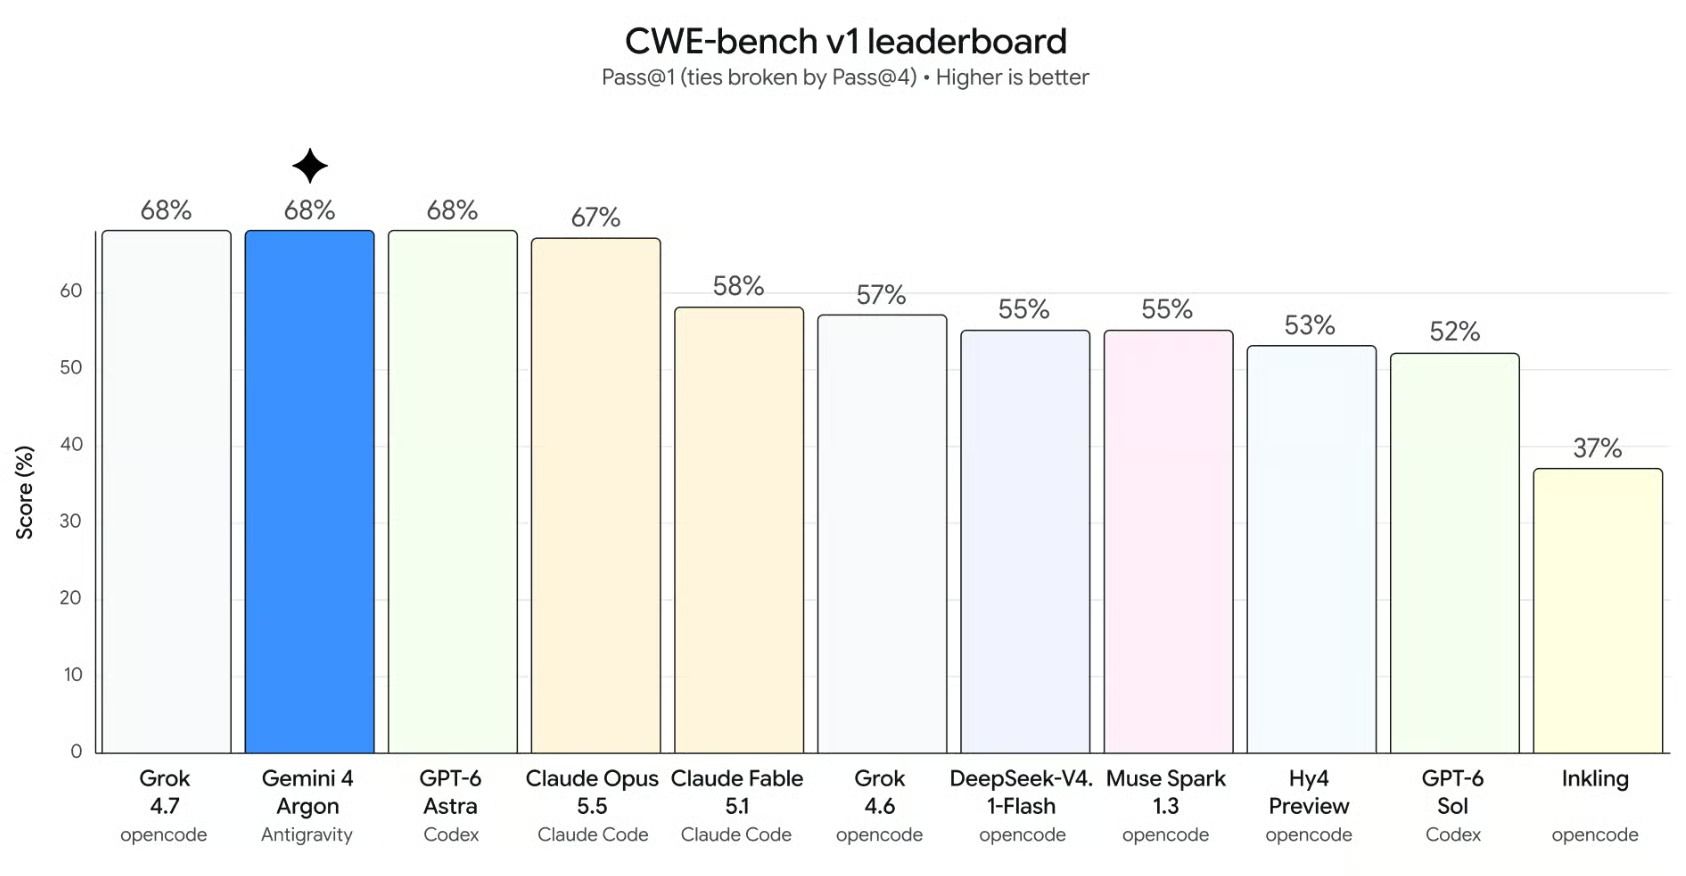
Trên CWE-bench v1, đánh giá liệu mô hình có thể khắc phục lỗ hổng bảo mật thực hay không, Argon hòa GPT-6 Astra ở vị trí đầu với 68%, Opus 5.5 đạt 67% và Fable 5.1 đạt 58%.
Một kết quả hòa là hợp lý ở đây, và Google thay vào đó xây dựng lập luận ở phía phát hiện.
So với 3.8 Flash Cyber, Google báo cáo rằng Argon đã phát hiện phơi lộ trên các codebase trải rộng 20 ngôn ngữ lập trình trong điểm chuẩn lỗ hổng nội bộ, và vượt 3.8 Flash Cyber trên điểm chuẩn kiểm thử xâm nhập hộp đen của Wiz ở năng lực lập bản đồ bề mặt tấn công, tìm lỗ hổng, và tạo bằng chứng proof-of-concept.
Hộp đen nghĩa là không có quyền truy cập mã nguồn, gần với cách một kẻ tấn công bên ngoài nhìn vào hệ thống web đang chạy.
Nơi Argon tụt lại
Google đã công bố cả các điểm thua, điều mà tôi đánh giá cao.
Có bốn điểm đáng nêu:
- FrontierSWE v2: Argon 55,0% so với 65,5% của GPT-6 Astra và 62,3% của Opus 5.5, tức hụt 10,5 điểm ở bộ SWE khó hơn trong hai bộ.
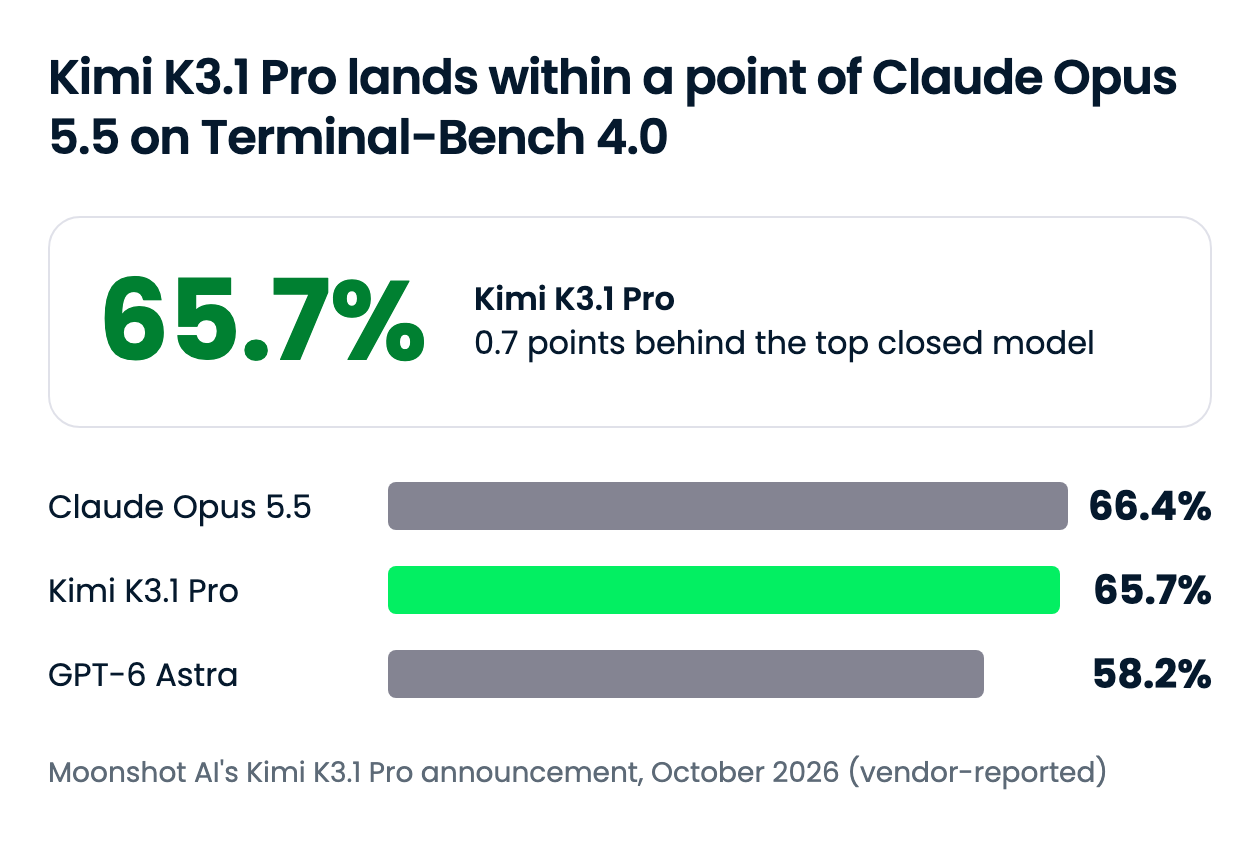
- Terminal-bench 4.0: Argon 57,4% so với Opus 5.5 ở mức 66,4%. Bài thử với Claude Sonnet 5.5 của chúng tôi đặt Sonnet tầm trung ở mức 70,6% trên cùng điểm chuẩn này, vậy Argon kém một mô hình có giá thấp hơn nhiều ở công việc agent điều khiển qua terminal.
- Terminal-Bench Science 0.1: Argon 57,6% so với 68,1% của Astra, hụt 10,5 điểm ở các tác vụ khoa học thực thi qua shell.
- PostTrainBench và OSWorld-2.0: Argon đạt 45,3% ở kỹ nghệ ML so với 49,3% của Opus 5.5, và 69,2% trên tập offline của OSWorld-2.0 so với 72,6% của Astra.
Argon vẫn giữ phong độ ở khoa học và toán nơi khác, với 88,8% trên LABBench 2 so với 85,4% của Astra và 68,6% của Fable 5.1, và 76,0% trên RiemannBench so với 72,0% của Astra.
Mẫu hình có thể thấy là Argon lập kế hoạch và đọc hiểu tốt hơn, trong khi Astra và Opus 5.5 vẫn lái terminal tốt hơn.
Dưới đây là bộ đầy đủ đã công bố, để bạn có thể tìm khối lượng công việc của mình trong đó.
| Điểm chuẩn | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|
| Vals Index | 68,9% | 63,1% | 65,8% | 67,0% |
| AutomationBench | 51,3% | 41,4% | 31,4% | 42,5% |
| Vals Finance Agent v2 | 65,4% | 53,5% | 58,9% | 58,6% |
| Harvey's Legal Agent Benchmark | 19,6% | 5,4% | 6,7% | 3,8% |
| DeepSWE v1.1 | 77,9% | 74,1% | 67,4% | 74,2% |
| FrontierSWE v2 | 55,0% | 65,5% | 56,3% | 62,3% |
| Vibe Code Bench | 91,9% | 89,6% | 90,3% | 90,3% |
| Terminal-bench 4.0 | 57,4% | 58,2% | 57,9% | 66,4% |
| PostTrainBench | 45,3% | 44,3% | 40,2% | 49,3% |
| Terminal-Bench Science 0.1 | 57,6% | 68,1% | 52,6% | 63,3% |
| LABBench 2 | 88,8% | 85,4% | 68,6% | 73,1% |
| RiemannBench | 76,0% | 72,0% | 65,6% | 69,6% |
| GraphWalks (tối đa 128K, BFS F1) | 99,7% | 98,7% | 91,4% | 90,6% |
| GraphWalks (256K đến 1M, BFS F1) | 84,2% | 71,8% | 65,0% | 66,8% |
| Agent's Last Exam (tỷ lệ vượt) | 39,5% | 34,2% | — | 38,2% |
| OSWorld-2.0 (tập offline) | 69,2% | 72,6% | — | — |
| Chartography | 71,6% | 71,0% | 46,2% | 66,3% |
| LVBench | 91,7% | 87,5% | 79,7% | 83,7% |
| CWE-bench v1 | 68,0% | 68,0% | 58,0% | 67,0% |
Google đang làm gì về an toàn trước khi phát hành rộng rãi
Google đang giữ Argon lại khỏi phát hành chung trong khi gia cố bốn mảng biện pháp bảo vệ, và đã nêu rõ cả bốn trong thông báo. Điều này quan trọng với bất kỳ ai có kế hoạch triển khai agent có quyền truy cập công cụ.
- Lạm dụng: Argon từ chối các yêu cầu liên quan đến an ninh mạng và CBRN trong khi vẫn bảo toàn nghiên cứu khoa học lưỡng dụng, theo Khung An toàn Tiên phong của Google, với các đội đỏ nội bộ và bên ngoài tiến hành tấn công thủ công và tự động. Google cũng giám sát các kích hoạt nội bộ của mô hình để phát hiện lạm dụng.
- Prompt injection gián tiếp: Google cho biết Argon dẫn đầu điểm chuẩn IPI của Gray Swan sau khi đội đỏ tự động và huấn luyện đối kháng.
- Lệch pha: Các bộ giám sát theo dõi chuỗi suy nghĩ và hành động và dừng thực thi khi Argon vượt quá ý định người dùng, và Google nói đã giữ các phát hiện đó ngoài dữ liệu huấn luyện để mô hình không học cách né tránh.
- Gia cố hệ thống: Môi trường sandbox được cô lập và niêm phong trước các lần huấn luyện hoặc đánh giá rủi ro cao, theo lộ trình kiểm soát agent của Google.
Giá của Gemini 4 Argon
Argon ra mắt với mức giá khởi điểm $2 cho mỗi triệu token đầu vào và $10 cho mỗi triệu token đầu ra, với token đầu vào lưu cache được giảm 95% so với mức đầu vào. Sau giai đoạn khởi điểm, mức giá tăng lên $4 cho mỗi triệu đầu vào và $20 cho mỗi triệu đầu ra. Google chưa công bố liệu token suy luận có bị tính theo mức đầu ra hay không.
So với thị trường, giá khởi điểm là quyết liệt, còn giá tiêu chuẩn thì không. Ở mức $2/$10, Argon khớp y hệt mức của GPT-6.1 Sol trong khi rẻ hơn 5 lần so với $10/$50 của GPT-6 Astra. Ở mức sau khuyến mãi $4/$20, nó trùng với mức chúng tôi ghi nhận cho Claude Opus 5.5 trong hướng dẫn API Opus 5.5.
Một góc nhìn chi phí nữa: giá theo token thô che giấu chi phí một tác vụ. Trong bài viết về GPT-6.1 Sol, chúng tôi ghi nhận $23,80 cho mỗi tác vụ Terminal-Bench Science 0.1 với GPT-6 Astra so với $5,47 với Sol, vì vậy một mô hình thắng điểm chuẩn vẫn có thể “thua” trên hóa đơn. Google chưa công bố chi phí theo tác vụ cho Argon, đây là con số tôi muốn có trước khi chuyển cả đội agent sang dùng.
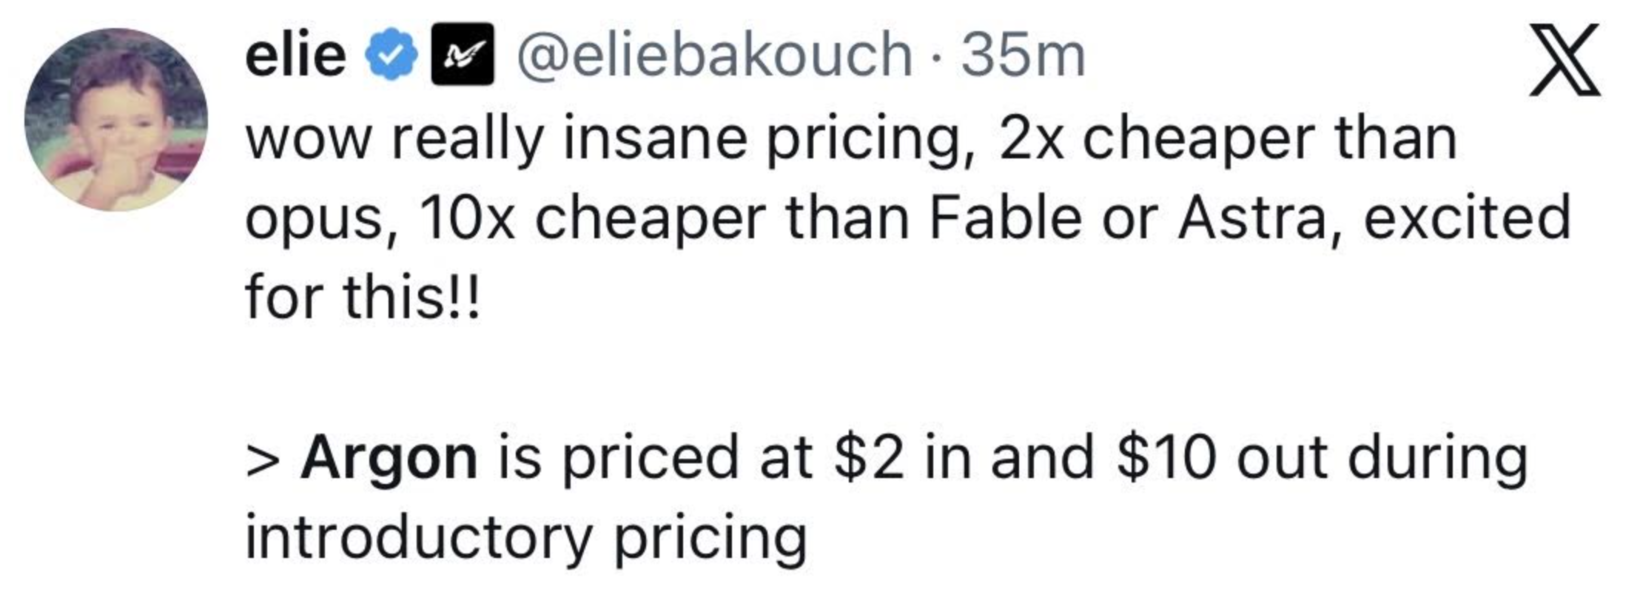
Google chưa công bố độ dài giai đoạn khởi điểm, nên hãy dự trù mức $4/$20 cho bất cứ thứ gì sống lâu hơn giai đoạn thí điểm.
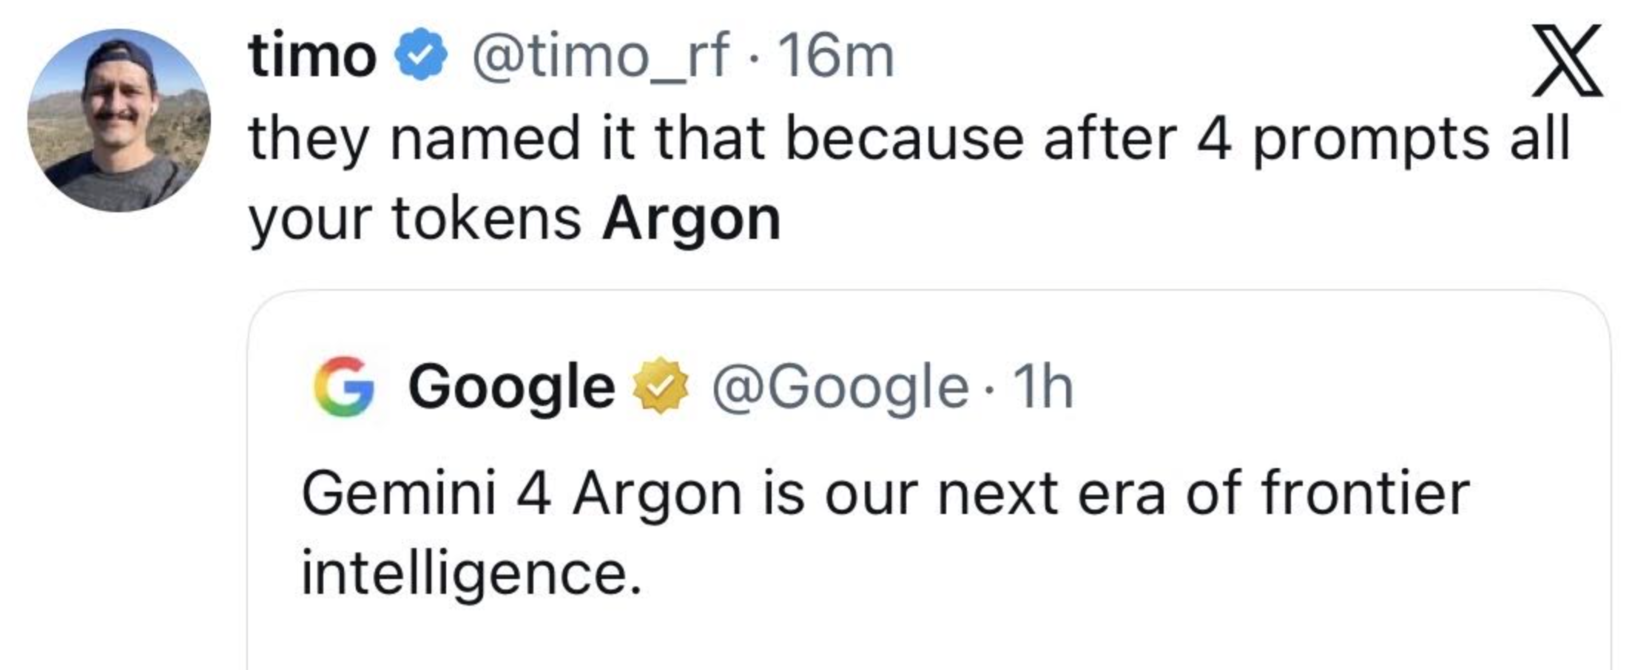
Hóa đơn xấp xỉ (giá mỗi token) × (số token sử dụng), và một mô hình có thể rẻ ở vế đầu nhưng đắt ở vế sau. Vì vậy, các chuỗi suy luận hoặc tư duy dài và câu trả lời dài dòng có thể đắt. Ngoài ra, với quy trình kiểu agent, có nhiều bước, nghĩa là mỗi bước gửi lại một ngữ cảnh ngày càng lớn, và chi phí đầu vào sẽ chồng lên. Đó là lý do một số người hoài nghi hơn về chi phí:
Cũng đáng lưu ý ở phía cạnh tranh: định vị của Anthropic vào tháng 9 năm 2026 cho Claude Opus 5.5 là hiệu năng tương đương Fable 5.1 với chi phí vận hành thấp hơn khoảng 40% so với Opus 5, nên áp lực Argon phải đối mặt ở mức giá tiêu chuẩn $4/$20 sẽ đến từ các mô hình rẻ hơn hơn là tốt hơn.
Tình trạng khả dụng của Gemini 4 Argon
Khả dụng mới là rào cản thực sự. Argon đang được triển khai tới một nhóm chuyên gia phòng thủ an ninh mạng đáng tin qua Chương trình Fairwind, và Google cho biết họ đang tham gia quy trình tự nguyện của chính phủ Hoa Kỳ để cấp quyền truy cập mô hình trước phát hành trong khi mở rộng dần. Truy cập phổ thông sẽ đến sau, bắt đầu với khách hàng API trả phí và người đăng ký Google AI Ultra. Không có tầng miễn phí, không có liên kết danh sách chờ, và không có hạn mức công bố trong thông báo.
Một điều cần theo dõi: trang giá AI công khai của Google được cập nhật lần cuối ngày 24 tháng 9 năm 2026, và các mức giá hiển thị ở đó ($0,75 đầu vào và $3,75 đầu ra mỗi triệu, khuyến mãi đến 31/12/2026, tăng lên $1,50/$7,50 vào 1/1/2027) thuộc tầng Gemini 3.8 Flash, không phải Argon.
Làm thế nào để truy cập Gemini 4 Argon?
Về cơ bản là chưa thể. Google chưa công bố model ID API cho Gemini 4 Argon, và tôi cũng sẽ không đoán từ tên marketing. Truy cập hiện tại đi qua nhóm Fairwind gồm các chuyên gia phòng thủ an ninh mạng đáng tin và các đội nội bộ của Google.
Tính đến ngày 30 tháng 9 năm 2026, Argon chưa có trong danh mục OpenRouter hay models.dev, và không xuất hiện trong tài liệu mô hình của Google Vertex AI, Gemini CLI, Cursor, hay GitHub Copilot. Trang mô hình của Azure AI Foundry và AWS Bedrock cũng chưa thể xác nhận. Khi mô hình đến tay khách hàng API trả phí, dạng lời gọi sẽ theo chuẩn Gemini:
from google import genai

client = genai.Client()
# Model ID for Gemini 4 Argon is not published as of September 30, 2026.
response = client.models.generate_content(
    model="<argon-model-id>",
    contents="Audit this module for memory-safety issues and propose a patch.",
)
print(response.text)
Nếu bạn muốn chuẩn bị phần “đường ống” trước, hướng dẫn API Claude Opus 5.5 của chúng tôi hướng dẫn xây dựng một agent điều tra với công cụ chỉ đọc và gọi công cụ theo lập trình, và các mẫu này có thể dùng chéo nhà cung cấp chỉ với việc thay model ID.
Mọi người đang nói gì về Gemini 4 Argon
Gần như không ai ngoài nhóm Fairwind đã dùng Argon, nên hầu hết phản hồi là ấn tượng ban đầu về thông báo, không phải thử nghiệm thực tế. Dưới đây là diễn biến cuộc trò chuyện, từ rộng đến cụ thể.
Bức tranh lớn / ấn tượng đầu tiên: mọi người bị thuyết phục.
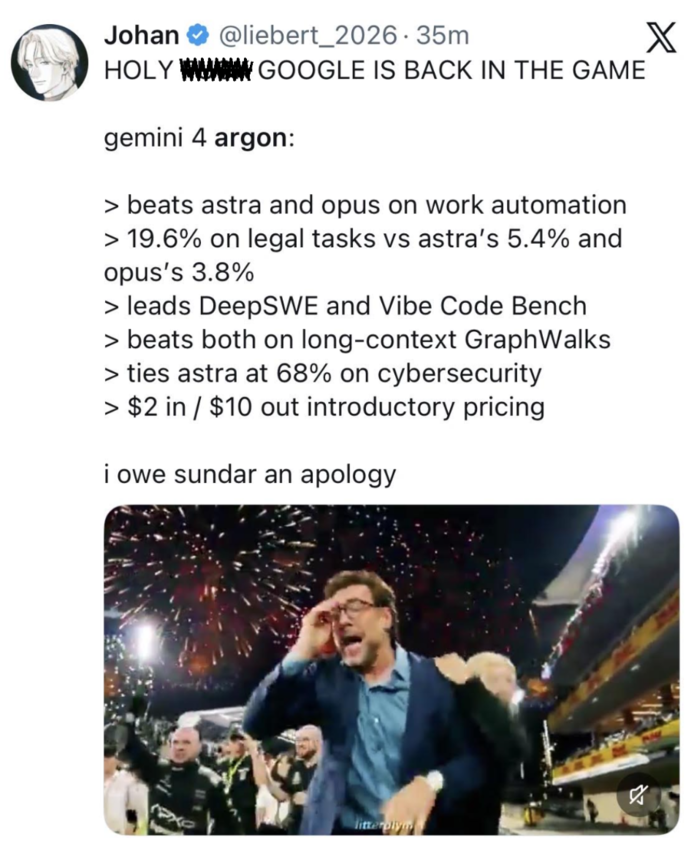
Ấn tượng đầu tiên không thể tách khỏi các điểm chuẩn. Hiệu năng trên Vals Index và kết quả pháp lý, tài chính thu hút nhiều chú ý nhất, kèm dấu hoa thị rằng tất cả đều là đánh giá của riêng Google.
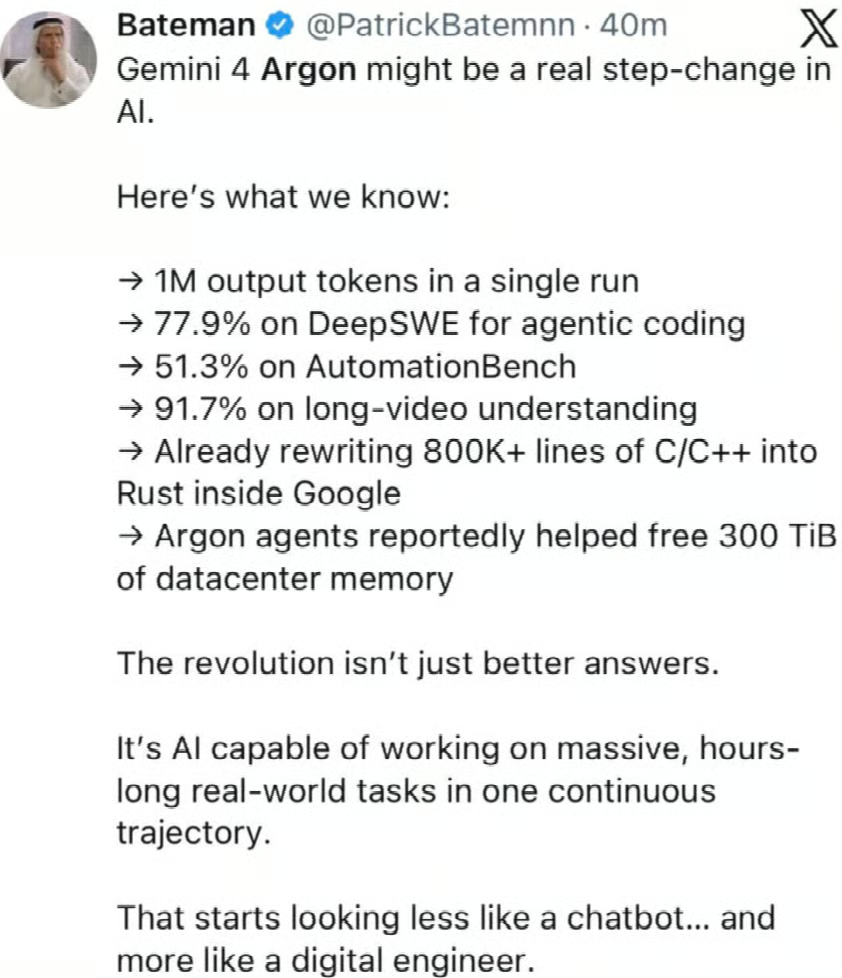
Nhưng có một phản ứng nắm bắt đúng ý nghĩa của bản phát hành này. Argon được xây dựng cho công việc kéo dài hàng giờ, như viết lại một kernel bằng Rust, và điều đó có thể tạo ra tác động thực sự tới tương lai công việc.
Kết luận
Google đang đặt cược rằng vòng cạnh tranh tiên phong tiếp theo sẽ được định đoạt ở công việc tri thức doanh nghiệp và phòng thủ an ninh mạng hơn là chất lượng trò chuyện, và các con số Vals Index, AutomationBench, và GraphWalks của Argon ủng hộ cược đó.
Tuy vậy, chưa ai ngoài nhóm Fairwind tái lập được dù chỉ một điểm số.
Khi mở cho người dùng thông thường, tôi sẽ chọn Argon cho công việc tài liệu và kho mã ngữ cảnh dài và ở lại với Claude Opus 5.5 hoặc GPT-6 Astra cho các vòng lặp agent điều khiển qua terminal, nơi Argon kém 9 đến 10 điểm.
Câu hỏi thường gặp
Gemini 4 Argon là gì?
Gemini 4 Argon là mô hình tiên phong của Google được công bố vào ngày 30 tháng 9 năm 2026 bởi Koray Kavukcuoglu của Google DeepMind. Mô hình hướng tới kỹ nghệ phần mềm dài hạn, công việc tri thức doanh nghiệp trong pháp lý và tài chính, và phòng thủ an ninh mạng. Thay đổi nổi bật là giới hạn token đầu ra 1 triệu, tăng từ 64K ở thế hệ trước.Gemini 4 Argon so với GPT-6 Astra và Claude Opus 5.5 thế nào?
Argon dẫn đầu ở công việc tri thức và ngữ cảnh dài: 68,9% trên Vals Index so với 67,0% của Claude Opus 5.5 và 63,1% của GPT-6 Astra, và 84,2% trên GraphWalks ở 256K đến 1M token so với 71,8% của Astra. Astra vẫn thắng FrontierSWE v2 (65,5% so với 55,0%) và Terminal-Bench Science 0.1 (68,1% so với 57,6%), và Opus 5.5 thắng Terminal-bench 4.0 ở mức 66,4% so với 57,4% của Argon.Gemini 4 Argon có giá bao nhiêu?
Argon ra mắt với giá khởi điểm $2 cho mỗi triệu token đầu vào và $10 cho mỗi triệu token đầu ra, với token đầu vào được lưu cache giảm 95% so với mức đầu vào. Sau giai đoạn khởi điểm, giá tăng lên $4 cho mỗi triệu đầu vào và $20 cho mỗi triệu đầu ra. Google chưa công bố thời lượng giai đoạn khởi điểm kéo dài bao lâu.Tôi có thể truy cập Gemini 4 Argon ở đâu?
Truy cập hiện giới hạn ở một nhóm chuyên gia phòng thủ an ninh mạng đáng tin thông qua Chương trình Fairwind của Google, cùng với các đội nội bộ của Google. Google cho biết phát hành rộng hơn sẽ bắt đầu với khách hàng API trả phí và người đăng ký Google AI Ultra. Tính đến ngày 30 tháng 9 năm 2026, chưa có model ID API được công bố, và Argon chưa có trong danh mục OpenRouter hay models.dev, cũng như trong tài liệu mô hình của Vertex AI, Gemini CLI, Cursor, hay GitHub Copilot.Vì sao Gemini 4 Argon được phát hành cho các đội an ninh mạng trước?
Google huấn luyện Argon để tự động tìm, xác thực, và vá lỗ hổng phần mềm, và đang phát hành mô hình không có hàng rào bảo vệ an ninh mạng cho các chuyên gia phòng thủ đáng tin để họ có đầy đủ năng lực phòng thủ. Wiz đã sử dụng mô hình này qua sáng kiến Scan for Good, nơi mô hình tìm thấy một lỗ hổng nghiêm trọng làm lộ thông tin cá nhân trong phần mềm y tế mà Google cho biết các mô hình tiên phong trước đó đã bỏ lỡ. Argon hòa GPT-6 Astra ở vị trí đầu trên CWE-bench v1 với 68%.Ứng dụng thực tế với STALI
Khi thử Gemini 4 Argon, chọn một bộ tác vụ đại diện như đọc tài liệu tiếng Việt, sửa lỗi mã và trả kết quả theo JSON, rồi đối chiếu chất lượng với thời gian xử lý. Với tài liệu dài, kiểm tra khả năng trích đúng dữ kiện và dẫn lại vị trí trong văn bản. Ghi riêng token đầu vào, đầu ra và bộ nhớ đệm để ước tính chi phí theo khối lượng công việc thực tế.
Kiểm tra mô hình đang được hỗ trợ và mức phí hiện hành tại bảng giá STALI. Giá nhà cung cấp được phân tích trong bài là dữ kiện tham khảo, không thay thế giá bán và điều kiện sử dụng trên STALI.
Để triển khai, đọc tài liệu tích hợp API STALI, sau đó đăng ký tài khoản STALI để quản lý khóa API và sử dụng các mô hình có trong danh mục.
Đọc thêm các phân tích liên quan trên STALI: