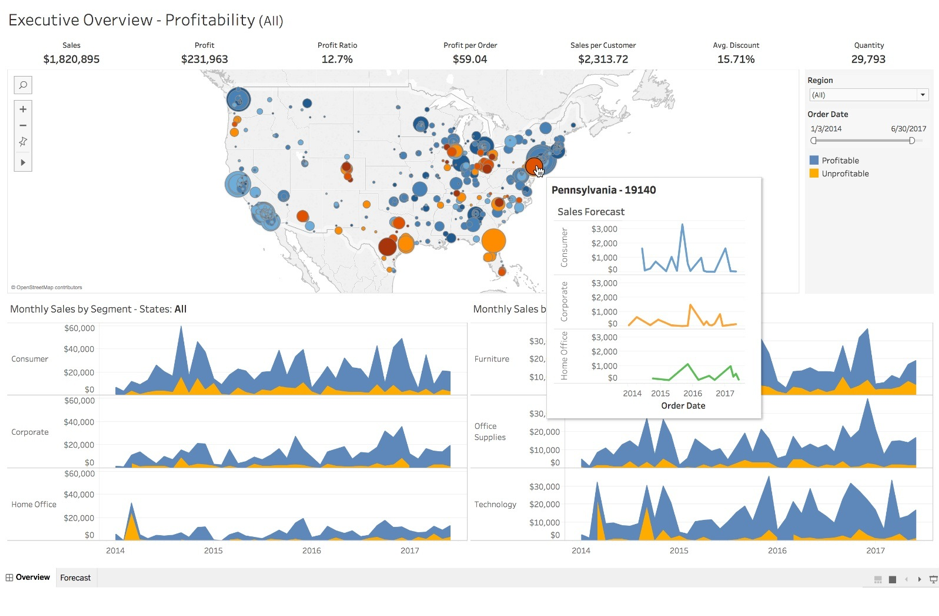
Hàng nghìn dòng dữ liệu có thể chứa xu hướng, ngoại lệ và các vấn đề mà người đọc khó nhận ra khi chỉ nhìn bảng thô. Trực quan hóa dữ liệu giúp đặt những thông tin đó vào bối cảnh để khám phá và trao đổi kết quả.
Tổ chức và cá nhân tận dụng dữ liệu để xác định nguyên nhân của vấn đề và tìm ra bước hành động cụ thể. Tuy nhiên, khi lượng dữ liệu ngày càng tăng, việc hiểu được toàn bộ càng trở nên thách thức. Bản năng của chúng ta là tìm kiếm các mẫu và cấu trúc. Đây là cách chúng ta lưu trữ thông tin và học ra các insight mới. Khi dữ liệu đầu vào không được trình bày một cách trực quan, việc nhìn thấy các mẫu và tìm cấu trúc có thể trở nên khó khăn, thậm chí trong một số trường hợp là không thể.
Trong bài viết này, chúng ta sẽ xem xét cách trực quan hóa dữ liệu có thể giải quyết vấn đề trên. Chúng ta cũng sẽ thảo luận data visualization là gì, tại sao nó quan trọng, mẹo phát triển kỹ năng, các dạng biểu đồ phổ biến và công cụ để trực quan hóa dữ liệu của bạn.
Data Visualization là gì?
Trực quan hóa dữ liệu là quá trình biểu diễn dữ liệu dưới dạng đồ họa, chẳng hạn biểu đồ, đồ thị, hoạt ảnh hoặc infographic. Mục tiêu là giúp nhận diện xu hướng, ngoại lệ và các mẫu trong dữ liệu.
Các chuyên gia dữ liệu thường xuyên dùng trực quan hóa để tóm tắt insight then chốt và truyền đạt lại thông tin đó cho các bên liên quan phù hợp.
Ví dụ, một chuyên gia dữ liệu có thể tạo biểu đồ cho đội ngũ quản lý, những người sau đó sử dụng các biểu đồ này để dự phóng cơ cấu tổ chức. Một ví dụ khác là khi các nhà khoa học dữ liệu dùng trực quan hóa để khám phá cấu trúc ẩn của dữ liệu nhằm hiểu dữ liệu của họ tốt hơn.
Với mục đích của trực quan hóa dữ liệu như đã nêu ở trên, có hai điểm then chốt chúng ta có thể rút ra:
1) Một cách để giúp dữ liệu dễ tiếp cận: Cách tốt nhất để làm cho thứ gì đó dễ tiếp cận là giữ mọi thứ đơn giản. Từ ‘đơn giản’ ở đây cần được đặt trong ngữ cảnh: điều dễ hiểu với một đứa trẻ mười tuổi có thể không giống với một người có bằng tiến sĩ. Vì vậy, trực quan hóa dữ liệu là kỹ thuật giúp dữ liệu dễ tiếp cận với người cần quan tâm.
2) Một cách để giao tiếp: Điểm này là phần mở rộng của điểm thứ nhất. Để giao tiếp hiệu quả, mọi người cần "nói cùng một ngôn ngữ". Dù bạn làm việc độc lập hay theo nhóm, các biểu đồ nên rút ra insight phù hợp với người xem. CEO có thể muốn xem các insight đưa ra bước hành động, còn nhóm machine learning có thể muốn xem insight về hiệu suất mô hình của họ.
Tóm lại, trực quan hóa dữ liệu là kỹ thuật giúp việc nhận ra các mẫu hoặc xu hướng trong dữ liệu trở nên dễ dàng hơn.
Tại sao trực quan hóa dữ liệu lại quan trọng với nhà khoa học dữ liệu?
Khoa học dữ liệu là lĩnh vực liên ngành sử dụng phương pháp khoa học, quy trình, thuật toán và hệ thống để trích xuất tri thức từ dữ liệu có cấu trúc và phi cấu trúc. Dữ liệu thô có thể khó diễn giải; trực quan hóa giúp đặt câu hỏi và khám phá những cấu trúc cần phân tích thêm.
Khả năng khám phá và học hỏi
Các nhà khoa học dữ liệu cần hiểu rõ dữ liệu họ sử dụng. Trực quan hóa giúp họ làm nổi bật những khía cạnh chứa nhiều thông tin nhất, giúp họ (và người khác) nhanh chóng nắm bắt điều gì đang diễn ra trong dữ liệu. Chẳng hạn, việc xác định xu hướng trong một bảng dữ liệu khó hơn nhiều so với khi nhìn thấy nó dưới dạng đồ thị. Chúng ta sẽ bàn thêm chi tiết về điều này ở phần sau.
Kể chuyện
Kể chuyện bằng dữ liệu kết hợp câu hỏi, bối cảnh, dữ kiện và cách trình bày để giúp người xem hiểu kết quả. Trực quan hóa là một thành phần của quá trình này; câu chuyện hấp dẫn vẫn phải dựa trên dữ liệu và thể hiện giới hạn của phân tích.
Hiệu quả
Trực quan hóa có thể hỗ trợ rà soát hiệu quả. Ví dụ, để xem các công ty lỗ trong một bộ dữ liệu giả định năm 2024, có thể đánh dấu lợi nhuận dưới 0, trên 0 và bằng 0. Hãy dùng cả nhãn hoặc ký hiệu cùng màu sắc để người có khiếm khuyết thị giác màu vẫn phân biệt được. Nếu cần danh sách đầy đủ, nên lọc theo điều kiện trong dữ liệu rồi dùng biểu đồ để kiểm tra và truyền đạt; nhìn biểu đồ không thay thế truy vấn chính xác.
Tính thẩm mỹ
Thiết kế gọn, nhãn rõ, tỷ lệ đúng và màu sắc có chủ đích giúp thông tin dễ đọc hơn. Thẩm mỹ hỗ trợ truyền đạt nhưng không chứng minh tính đúng đắn; một biểu đồ đẹp vẫn có thể gây hiểu nhầm nếu dữ liệu, trục hoặc bối cảnh sai.
Cách học Data Visualization
Trực quan hóa là kỹ năng hữu ích cho nhà phân tích kinh doanh và nhà khoa học dữ liệu. Có thể luyện tập theo năm bước sau, từ hiểu dạng biểu đồ đến xây dựng một dự án có thể kiểm tra lại.
Đây là cách bạn có thể bắt đầu:
1. Bắt đầu với những điều cơ bản
Bắt đầu bằng việc đọc và diễn giải các biểu đồ đơn giản, hiểu khi nào mỗi dạng phù hợp trước khi dùng công cụ nâng cao.
- Các dạng biểu đồ cơ bản: cột, tròn và đường.
- Các lỗi thường gặp khi thiết kế hoặc diễn giải biểu đồ.
- Cách chọn dạng biểu đồ phù hợp với dữ liệu và câu hỏi.
2. Học trực quan hóa bằng công cụ không cần code
Có thể bắt đầu bằng công cụ có giao diện kéo thả như Power BI hoặc Tableau để làm quen với báo cáo và dashboard tương tác. Việc chuẩn bị dữ liệu và các phép tính nâng cao vẫn có thể cần công thức hoặc mã.
- Xây dựng dashboard tương tác.
- Làm sạch và chuẩn bị dữ liệu trước khi trực quan hóa.
- Thực hành kể chuyện bằng dữ liệu với nhãn và bối cảnh rõ ràng.
3. Phát triển kỹ năng lập trình cho các biểu đồ nâng cao
Nếu bạn đã sẵn sàng "động tay vào code", học cách tạo trực quan hóa bằng Python hoặc R sẽ mở rộng đáng kể khả năng tùy biến và tự động hóa của bạn.
- Tạo biểu đồ tùy biến bằng Matplotlib, Seaborn hoặc ggplot2.
- Hiểu histogram, heatmap và biểu đồ phân tán.
- Tạo trực quan hóa tương tác bằng Plotly hoặc Shiny.
4. Luyện tập qua dự án
Sau khi nắm cơ bản, hãy luyện tập trên một bộ dữ liệu có nguồn và điều kiện sử dụng rõ ràng. Làm từ câu hỏi, chuẩn bị dữ liệu đến biểu đồ và ghi lại các giới hạn của kết quả.
- Khám phá xu hướng sản xuất bộ LEGO bằng Matplotlib và Seaborn khi có bộ dữ liệu phù hợp.
- Dùng biểu đồ đường và diện tích để khám phá thay đổi tỷ lệ giới tính trong các nhóm bằng đại học, ghi rõ năm, phạm vi và cách đo.
5. Tiếp tục học và cập nhật
Theo dõi tài liệu và ghi chú phiên bản của công cụ đang dùng. Khi cập nhật thư viện, hãy chạy lại ví dụ và kiểm tra nhãn, kiểu dữ liệu cùng kết quả.
- Tự ghi một bảng tham khảo về dạng biểu đồ, mục đích và lỗi thường gặp.
- Khi cần tương tác, có thể tìm hiểu Dash của Plotly hoặc D3.js; lựa chọn theo yêu cầu và khả năng bảo trì.
Công cụ Trực quan hóa Dữ liệu
Các chuyên gia dữ liệu, như nhà khoa học dữ liệu và nhà phân tích dữ liệu, thường tận dụng công cụ trực quan hóa để làm việc hiệu quả hơn và truyền đạt phát hiện một cách hiệu quả hơn.
Các công cụ có thể chia thành hai nhóm: 1) không cần code và 2) dựa trên code. Hãy xem một số công cụ phổ biến trong từng nhóm.
Công cụ không cần code
Không phải ai trong tổ chức của bạn cũng rành công nghệ. Tuy nhiên, việc không biết lập trình không nên ngăn bạn rút ra insight từ dữ liệu. Bạn có thể không biết lập trình nhưng vẫn có thể có hiểu biết về dữ liệu – tức có thể đọc, viết, giao tiếp và lý luận với dữ liệu để đưa ra quyết định tốt hơn.
Công cụ có giao diện đồ họa giúp thực hiện nhiều thao tác mà không phải tự viết chương trình. Đây là cách tương tác, không phải cam kết rằng mọi tính năng đều không cần mã: mô hình dữ liệu, phép tính và tích hợp có thể dùng công thức hoặc ngôn ngữ riêng.
Một số ví dụ về công cụ không cần code bao gồm:
Power BI
Power BI của Microsoft hỗ trợ kết nối và chuẩn bị dữ liệu, xây dựng mô hình, báo cáo và dashboard. Giao diện giúp thực hiện nhiều thao tác trực quan; các phép tính hoặc biến đổi nâng cao có thể dùng DAX và Power Query M.
Tableau
Tableau hỗ trợ khám phá dữ liệu và xây dựng các trực quan hóa tương tác bằng giao diện kéo thả. Người dùng vẫn cần hiểu cấu trúc dữ liệu, cách tổng hợp và các phép tính để diễn giải đúng kết quả.
ChatGPT
ChatGPT có thể hỗ trợ phân tích tệp dữ liệu và tạo biểu đồ khi tài khoản có công cụ tương ứng. Hãy kiểm tra các phép tính, bộ lọc, trục và dữ liệu đầu vào; đầu ra AI có thể sai. Không tải dữ liệu cá nhân hoặc dữ liệu doanh nghiệp nhạy cảm lên dịch vụ bên ngoài khi chưa được phép.
Trực quan hóa bằng code
Nếu bạn rành công nghệ hơn, bạn có thể thích dùng ngôn ngữ lập trình để trực quan hóa dữ liệu. Sự gia tăng sản xuất dữ liệu đã thúc đẩy độ phổ biến của Python và R nhờ nhiều gói hỗ trợ xử lý dữ liệu.
Hãy xem một số gói này.
Các gói Python
Python là ngôn ngữ lập trình bậc cao, thông dịch, đa dụng. Nó cung cấp nhiều gói vẽ biểu đồ tuyệt vời cho trực quan hóa dữ liệu, chẳng hạn:
- Matplotlib
- Seaborn
- Plotly
- Bokeh
Các gói R
R là ngôn ngữ cho tính toán thống kê và đồ họa. Các gói dưới đây hỗ trợ nhiều tác vụ trực quan hóa; trong code, hãy dùng đúng tên gói như trong tài liệu. RColorBrewer cung cấp bảng màu, còn leaflet hỗ trợ bản đồ web tương tác.
- ggplot2
- lattice
- highcharter
- leaflet
- RColorBrewer
- plotly
Các biểu đồ phổ biến dùng trong trực quan hóa dữ liệu
Phần này minh họa bảng tần suất và các biểu đồ phổ biến bằng Python. Bảng tần suất dùng pandas; phần lớn biểu đồ dùng Matplotlib, heatmap dùng thêm seaborn và treemap dùng Plotly. Các ví dụ phục vụ học kỹ thuật, không phải số liệu hoạt động của STALI.
Các ví dụ dưới đây đã được biên tập để phục hồi xuống dòng bị mất trong bản hiển thị nguồn. Dữ liệu minh họa không phải số liệu kinh doanh hay phép đo của STALI. Bảng tần suất dùng bộ Car Evaluation của UCI; treemap dùng dữ liệu Gapminder năm 2007 có sẵn trong Plotly. Ảnh giữ nguyên là kết quả minh họa trong tài liệu gốc, không phải kết quả đo mới.
Chuẩn bị để chạy các ví dụ
Dùng một môi trường Python riêng và cài các thư viện cần thiết bằng python -m pip install numpy pandas matplotlib seaborn plotly. Các ví dụ đã được đối chiếu với NumPy 2.0.2, pandas 2.3.3, Matplotlib 3.9.4, Seaborn 0.13.2 và Plotly 7.1.0; đây là các phiên bản kiểm tra, không phải tuyên bố là phiên bản mới nhất. Dùng phiên bản Python còn được hỗ trợ và tương thích với các thư viện bạn cài.
Với ví dụ đầu, mở trang Car Evaluation chính thức của UCI, tải gói dữ liệu và giải nén car.data vào thư mục làm việc. Tệp không có hàng tiêu đề; tên bảy cột được khai báo trong code. Tài liệu UCI ghi bộ dữ liệu có 1.728 bản ghi và cấp phép CC BY 4.0. Các ví dụ còn lại tự tạo dữ liệu minh họa hoặc dùng bộ dữ liệu có sẵn trong Plotly. Matplotlib hiển thị trong cửa sổ hoặc notebook tùy backend; Plotly cần renderer phù hợp để tương tác.
Bảng tần suất
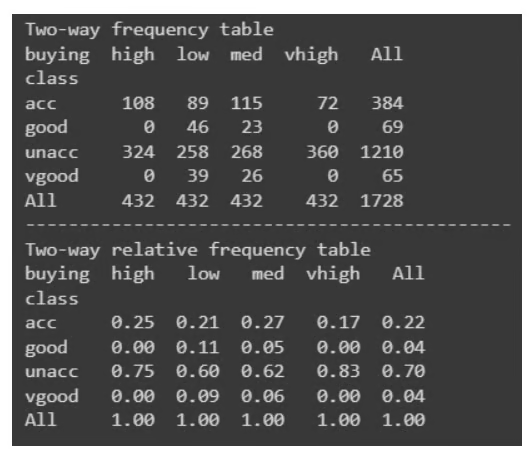
Bảng tần suất đếm số quan sát theo từng nhóm. Bảng hai chiều giúp xem phân bố giữa hai biến phân loại; nó không tự chứng minh một đặc trưng gây ra kết quả hay quyết định.
Ví dụ dùng bộ Car Evaluation của UCI, gồm 1.728 dòng, sáu thuộc tính phân loại và biến đích class. Tải gói dữ liệu, giải nén và đặt car.data trong thư mục làm việc trước khi chạy. Ghi nguồn: Bohanec, M. (1988), Car Evaluation, UCI Machine Learning Repository, DOI 10.24432/C5JP48, CC BY 4.0. Code khai báo thứ tự bảy cột và dùng pandas để đếm theo class và buying.
import pandas as pd
"""source: https://heartbeat.comet.ml/exploratory-data-analysis-eda-for-categorical-data-870b37a79b65"""
# Download and extract car.data from the linked UCI Car Evaluation dataset first.
car_data = pd.read_csv(
    "car.data",
    names=["buying", "maint", "doors", "persons", "lug_boot", "safety", "class"],
)

def frequency_table(data:pd.DataFrame, col:str, column:str):
    freq_table = pd.crosstab(index=data[col],
                            columns=data[column],
                                     margins=True)
    rel_table = round(freq_table/freq_table.loc["All"], 2)
    return freq_table, rel_table
buying_freq, buying_rel = frequency_table(car_data, "class", "buying")
print("Two-way frequency table")
print(buying_freq)
print("---" * 15)
print("Relative frequencies within each buying-price column")
print(buying_rel)
| class | high | low | med | vhigh | All |
|---|---|---|---|---|---|
| acc | 108 | 89 | 115 | 72 | 384 |
| good | 0 | 46 | 23 | 0 | 69 |
| unacc | 324 | 258 | 268 | 360 | 1210 |
| vgood | 0 | 39 | 26 | 0 | 65 |
| All | 432 | 432 | 432 | 432 | 1728 |
| class | high | low | med | vhigh | All |
|---|---|---|---|---|---|
| acc | .25 | .21 | .27 | .17 | .22 |
| good | .00 | .11 | .05 | .00 | .04 |
| unacc | .75 | .60 | .62 | .83 | .70 |
| vgood | .00 | .09 | .06 | .00 | .04 |
| All | 1.00 | 1.00 | 1.00 | 1.00 | 1.00 |
Biểu đồ cột
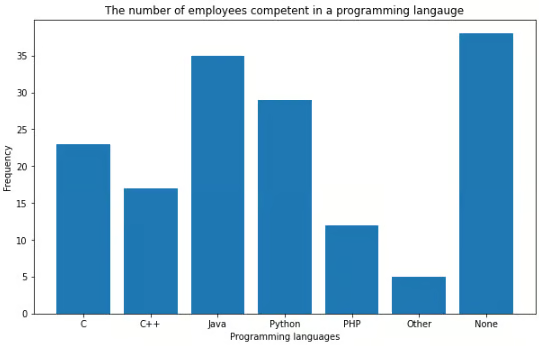
Biểu đồ cột là một trong những trực quan hóa đơn giản nhưng hiệu quả nhất. Thường được dùng để so sánh khác biệt giữa các danh mục. Ví dụ, ta có thể dùng biểu đồ cột để biểu diễn số lượng vụ gian lận so với không gian lận. Một trường hợp khác là biểu diễn tần suất mỗi mức sao đánh giá cho một bộ phim.
Dưới đây là cách tạo biểu đồ cột trong Python:
"""Starter code from tutorials point
see: https://bit.ly/3x9Z6HU"""
import matplotlib.pyplot as plt
# Dataset creation.
programming_languages = ['C', 'C++', 'Java', 'Python', 'PHP', "Other", "None"]
employees_frequency = [23, 17, 35, 29, 12, 5, 38]
# Bar graph creation.
fig, ax = plt.subplots(figsize=(10, 5))
plt.bar(programming_languages, employees_frequency)
plt.title("The number of employees competent in a programming language")
plt.xlabel("Programming languages")
plt.ylabel("Frequency")
plt.show()
Biểu đồ tròn
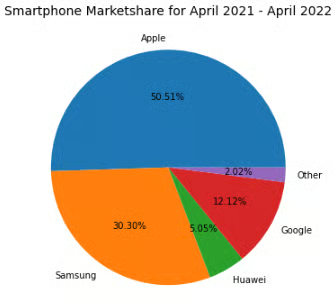
Biểu đồ tròn cũng là công cụ trực quan hóa đơn giản và hiệu quả. Thường dùng để hiển thị và so sánh các phần của tổng thể. Ví dụ, một trường hợp phù hợp là biểu diễn thị phần điện thoại thông minh. Hãy triển khai điều này bằng Python.
"""Example to demonstrate how a pie chart can be used to represent the market
share for smartphones.
Note: These are not real figures. They were created for demonstration purposes."""
import numpy as np
from matplotlib import pyplot as plt
# Dataset creation.
smartphones = ["Apple", "Samsung", "Huawei", "Google", "Other"]
market_share = [50, 30, 5, 12, 2]
# Pie chart creation
fig, ax = plt.subplots(figsize=(10, 6))
plt.pie(market_share,
        labels = smartphones,
        autopct='%1.2f%%', normalize=True)
plt.title("Illustrative smartphone weights (normalized to 100%)",
          fontsize=14)
plt.show()
Đồ thị đường và biểu đồ diện tích
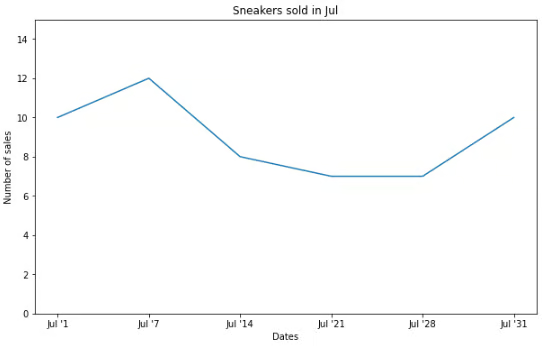
Đồ thị đường rất phù hợp để trực quan hóa xu hướng hoặc tiến trình theo thời gian. Ví dụ, ta có thể biểu diễn số lượng giày thể thao bán ra trong tháng Bảy bằng đồ thị đường.
import matplotlib.pyplot as plt
# Data creation.
sneakers_sold = [10, 12, 8, 7, 7, 10]
dates = ["Jul '1", "Jul '7", "Jul '14", "Jul '21", "Jul '28", "Jul '31"]
# Line graph creation
fig, ax = plt.subplots(figsize=(10, 6))
plt.plot(dates, sneakers_sold)
plt.title("Sneakers sold in Jul")
plt.ylim(0, 15) # Change the range of y-axis.
plt.xlabel("Dates")
plt.ylabel("Number of sales")
plt.show()
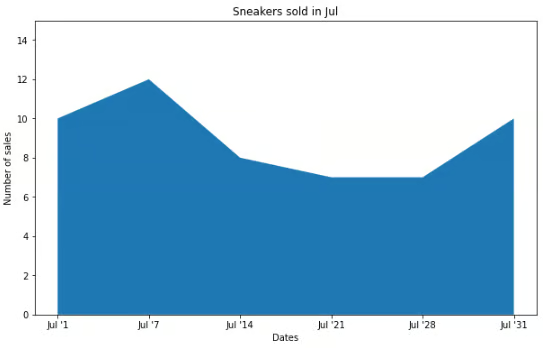
Biểu đồ diện tích là phần mở rộng của đồ thị đường, nhưng khác ở chỗ vùng dưới đường được tô màu hoặc họa tiết.
Dưới đây là chính dữ liệu trên được vẽ dưới dạng biểu đồ diện tích:
import matplotlib.pyplot as plt
sneakers_sold = [10, 12, 8, 7, 7, 10]
dates = ["Jul '1", "Jul '7", "Jul '14", "Jul '21", "Jul '28", "Jul '31"]

# Area chart creation
fig, ax = plt.subplots(figsize=(10, 6))
plt.fill_between(dates, sneakers_sold)
plt.title("Sneakers sold in Jul")
plt.ylim(0, 15) # Change the range of y-axis.
plt.xlabel("Dates")
plt.ylabel("Number of sales")
plt.show()
Cũng khá phổ biến khi thấy biểu đồ diện tích xếp chồng để minh họa sự thay đổi của nhiều biến theo thời gian. Ví dụ, ta có thể biểu diễn theo thương hiệu giày bán ra trong tháng Bảy thay vì tổng doanh số bằng biểu đồ diện tích xếp chồng.
import matplotlib.pyplot as plt

# Data creation.
sneakers_sold = [[3, 4, 2, 4, 3, 1], [3, 2, 6, 1, 3, 5], [4, 6, 0, 2, 1, 4]]
dates = ["Jul '1", "Jul '7", "Jul '14", "Jul '21", "Jul '28", "Jul '31"]
# Multiple area chart creation
fig, ax = plt.subplots(figsize=(10, 6))
plt.stackplot(dates, sneakers_sold, labels=["Nike", "Adidas", "Puma"])
plt.title("Sneakers sold in Jul")
plt.ylim(0, 15) # Change the range of y-axis.
plt.xlabel("Dates")
plt.ylabel("Number of sales")
plt.legend()
plt.show()
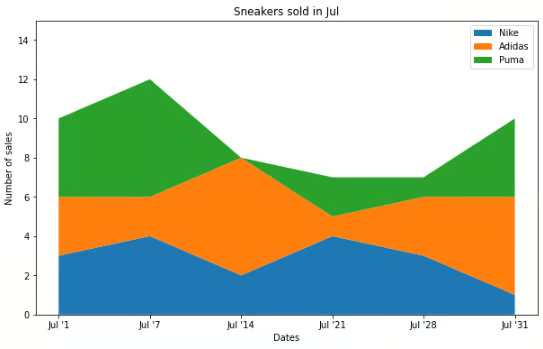
Ba ví dụ đường, diện tích và diện tích xếp chồng có cùng tổng ở sáu mốc: 10, 12, 8, 7, 7 và 10. Nhãn ngày trong code đang được xử lý như sáu hạng mục cách đều, dù khoảng cách lịch là 6, 7, 7, 7 và 3 ngày. Vì vậy không diễn giải độ dốc thành tốc độ bán theo ngày hoặc cộng thành tổng tháng; khi cần trục thời gian thật, hãy dùng đối tượng ngày và xác định số đo tại mỗi mốc.
Histogram
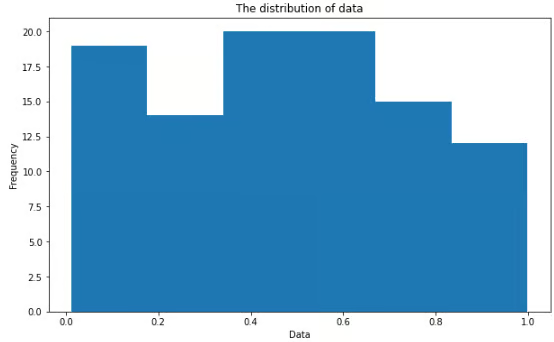
Histogram được dùng để biểu diễn phân phối của một biến số.
import numpy as np
import matplotlib.pyplot as plt
data = np.random.sample(size=100) # Graph will change with each run
fig, ax = plt.subplots(figsize=(10, 6))
plt.hist(data, bins=6)
plt.title("The distribution of data")
plt.xlabel("Data")
plt.ylabel("Frequency")
plt.show()
Biểu đồ phân tán
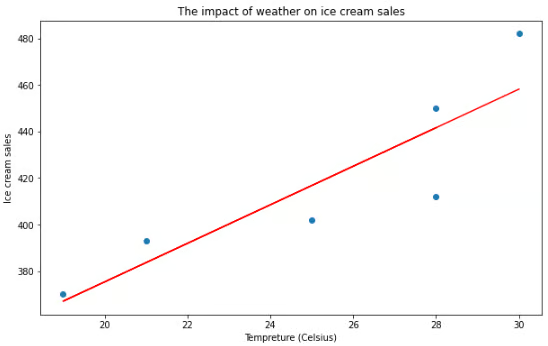
Biểu đồ phân tán thể hiện mối liên hệ giữa hai biến. Có thể thêm đường hồi quy để mô tả xu hướng trong mẫu, nhưng tương quan và đường hồi quy không chứng minh quan hệ nhân quả. Ví dụ dưới đây dùng sáu cặp nhiệt độ và số kem bán giả định.
import numpy as np
import matplotlib.pyplot as plt
# Data creation.
temperature = np.array([30, 21, 19, 25, 28, 28]) # Degree's celsius
ice_cream_sales = np.array([482, 393, 370, 402, 412, 450])
# Calculate the line of best fit
X_reshape = temperature.reshape(temperature.shape[0], 1)
X_reshape = np.append(X_reshape, np.ones((temperature.shape[0], 1)), axis=1)
y_reshaped = ice_cream_sales.reshape(ice_cream_sales.shape[0], 1)
theta = np.linalg.lstsq(X_reshape, y_reshaped, rcond=None)[0]
best_fit = X_reshape.dot(theta)
# Create and plot scatter chart
fig, ax = plt.subplots(figsize=(10, 6))
plt.scatter(temperature, ice_cream_sales)
plt.plot(temperature, best_fit, color="red")
plt.title("Temperature and ice cream sales (illustrative data)")
plt.xlabel("Temperature (Celsius)")
plt.ylabel("Ice cream sales")
plt.show()
Heatmap
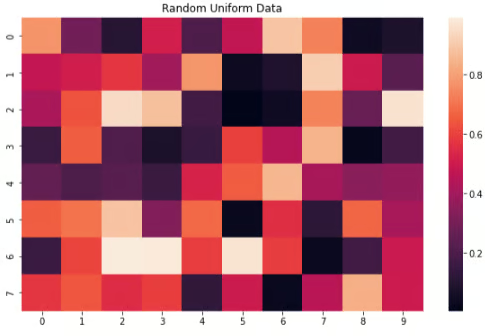
Heatmap ánh xạ giá trị tại mỗi ô hoặc vị trí sang màu sắc. Ví dụ, hàng và cột có thể biểu diễn hai nhóm, còn màu biểu diễn một đại lượng như tần suất hoặc nhiệt độ. Màu đỏ chỉ có nghĩa mưa lớn nếu chú giải quy định như vậy; không phải mọi dữ liệu ba chiều đều phù hợp với heatmap.
Để minh họa cách tạo heatmap trong Python, chúng ta sẽ dùng thêm thư viện Seaborn – thư viện trực quan hóa cấp cao dựa trên Matplotlib.
import numpy as np
import seaborn as sns
import matplotlib.pyplot as plt
data = np.random.rand(8, 10) # Graph will change with each run
fig, ax = plt.subplots(figsize=(10, 6))
sns.heatmap(data)
plt.title("Random Uniform Data")
plt.show()
Treemap
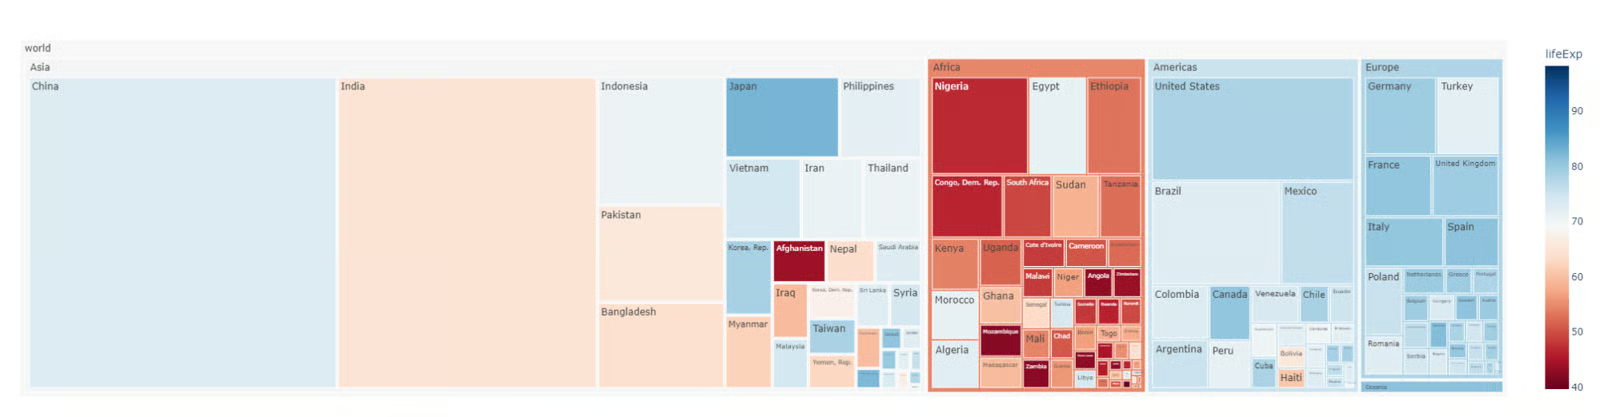
Treemap biểu diễn dữ liệu phân cấp bằng các hình chữ nhật lồng nhau. Diện tích biểu diễn độ lớn không âm của một đại lượng; màu có thể mã hóa đại lượng khác. Trong ví dụ này, diện tích là dân số và màu là tuổi thọ kỳ vọng tính bằng năm trong dữ liệu Gapminder năm 2007, không phải số liệu hiện tại.
Để xây dựng treemap trong Python, chúng ta sẽ dùng thêm thư viện Plotly, vốn dùng để tạo biểu đồ tương tác.
"""Source: https://plotly.com/python/treemaps/"""
import plotly.express as px
import numpy as np
df = px.data.gapminder().query("year == 2007")
fig = px.treemap(df, path=[px.Constant("world"), 'continent', 'country'], values='pop',
                  color='lifeExp', hover_data=['iso_alpha'],
                  color_continuous_scale='RdBu',
                  color_continuous_midpoint=np.average(df['lifeExp'], weights=df['pop']))
fig.update_layout(margin = dict(t=50, l=25, r=25, b=25))
fig.show()
3 mẹo để trực quan hóa dữ liệu hiệu quả
Trực quan hóa dữ liệu là một nghệ thuật. Phát triển kỹ năng đòi hỏi thời gian và thực hành. Dưới đây là ba mẹo giúp bạn đi đúng hướng:
Mẹo #1: Đặt một câu hỏi cụ thể
Bước đầu tiên và quan trọng nhất để tạo trực quan hóa hiệu quả là có một câu hỏi rõ ràng và cụ thể. Nếu không, bạn có nguy cơ tạo ra biểu đồ thiếu trọng tâm và khó diễn giải.
- Ví dụ: Nếu bạn đang phân tích dữ liệu bán hàng, thay vì hỏi “Doanh số năm nay đang xu hướng thế nào?”, hãy cụ thể hơn: “Doanh số trực tuyến tại Mỹ cho sản phẩm X thay đổi thế nào trong quý 3 so với quý 2?”
Câu hỏi chính xác giúp bạn tập trung biểu đồ để trả lời trực tiếp, tránh thông tin không cần thiết gây nhiễu hoặc quá tải người xem.
- Ví dụ không tốt: Một dashboard rối rắm hiển thị tổng doanh số trên tất cả khu vực, loại sản phẩm và kênh bán hàng trong 5 năm qua.
- Ví dụ tốt: Biểu đồ cột đơn giản chỉ tập trung vào doanh số trực tuyến tại Mỹ quý 2 so với quý 3 cho một sản phẩm cụ thể.
Mẹo #2: Chọn dạng trực quan hóa phù hợp
Không phải biểu đồ nào cũng như nhau. Chọn sai loại biểu đồ có thể làm sai lệch thông điệp và gây nhầm lẫn cho người xem. Mỗi loại biểu đồ có thế mạnh riêng và phù hợp với từng kiểu dữ liệu cụ thể.
- Ví dụ: Nếu bạn muốn thể hiện tỷ trọng trong tổng thể, biểu đồ tròn có thể phù hợp. Nhưng nếu so sánh thay đổi theo thời gian, đồ thị đường hoặc biểu đồ cột sẽ thích hợp hơn.
Chọn loại biểu đồ đúng:
- Biểu đồ cột: Dùng khi so sánh các danh mục khác nhau.
- Đồ thị đường: Tốt nhất để hiển thị xu hướng theo thời gian.
- Biểu đồ tròn: Lý tưởng để hiển thị tỷ trọng của tổng thể.
- Biểu đồ phân tán: Hữu ích để xác định mối quan hệ giữa hai biến.
- Ví dụ không tốt: Dùng biểu đồ tròn để thể hiện thay đổi doanh thu theo thời gian.
- Ví dụ tốt: Dùng đồ thị đường để làm nổi bật thay đổi doanh thu theo tháng, giúp dễ nhận ra xu hướng.
Kết luận: Hãy ghép loại biểu đồ với câu hỏi hoặc dữ liệu cụ thể của bạn để tăng độ rõ ràng.
Mẹo #3: Làm nổi bật thông tin quan trọng nhất
Khi tạo trực quan hóa, điều quan trọng là hướng sự chú ý của khán giả vào insight chủ chốt. Việc sử dụng màu sắc, kích thước và các yếu tố thiết kế một cách hiệu quả có thể giúp bạn nhấn mạnh điều quan trọng nhất.
- Ví dụ: Hình dung bạn đang hiển thị dữ liệu doanh thu cho nhiều sản phẩm. Bằng cách dùng màu đậm cho sản phẩm bán chạy và tông màu nhẹ cho sản phẩm khác, bạn giúp người xem dễ tập trung vào thông tin cốt lõi.
Dưới đây là cách bạn có thể làm nổi bật thông tin quan trọng:
- Dùng màu tương phản và nhãn để làm rõ các điểm cần chú ý.
- Dùng viền hoặc chú thích để nhấn mạnh. Nếu kích thước điểm đang mã hóa một giá trị số, giữ nguyên thang kích thước để không làm sai lệch dữ liệu.
- Thêm giải thích ngắn bên cạnh điểm hoặc vùng quan trọng.
- Ví dụ cần cải thiện: nhiều điểm chồng lấp hoặc thiếu nhãn khiến thông điệp khó đọc. Các điểm cùng màu và cùng kích thước vẫn có thể phù hợp với biểu đồ chỉ thể hiện hai biến số.
- Ví dụ có chủ đích: chú thích ngoại lệ và dùng màu phân nhóm khi việc phân nhóm giúp trả lời câu hỏi, kèm chú giải rõ ràng.
Kết luận: Những lựa chọn thiết kế tinh tế như màu sắc, kích thước và nhãn có thể cải thiện đáng kể khả năng nắm bắt insight nhanh chóng của người xem.
Kết luận
Tựu trung, một trực quan hóa hiệu quả dựa vào khuynh hướng tự nhiên của chúng ta trong việc nhận ra các mẫu. Việc dùng màu sắc, hình dạng, kích thước, v.v. là kỹ thuật cực kỳ hiệu quả để nhấn mạnh thông tin quan trọng nhất bạn muốn hiển thị.
Để cải thiện kỹ năng, hãy lặp lại ba bước: đặt câu hỏi cụ thể, chọn dạng trực quan hóa phù hợp và làm nổi bật thông tin quan trọng. Sau mỗi lần thử, kiểm tra dữ liệu, đơn vị, cách tổng hợp, trục, chú thích và phản hồi của người đọc.
Tài liệu kỹ thuật để đối chiếu
- pandas.crosstab
- Matplotlib: biểu đồ tròn và chuẩn hóa
- Matplotlib: trục hạng mục
- NumPy: bình phương tối thiểu
- Seaborn: heatmap
- Plotly: treemap và ví dụ Gapminder
- Power BI: tổng quan chức năng
- Tableau: xây dựng biểu đồ bằng trường dữ liệu
- ChatGPT: phân tích bộ dữ liệu và báo cáo
Câu hỏi thường gặp
Những lỗi thường gặp nhất trong trực quan hóa dữ liệu là gì?
Các lỗi phổ biến gồm nhồi nhét quá nhiều dữ liệu vào biểu đồ, khiến người xem bị quá tải. Một lỗi khác là chọn sai loại biểu đồ, như dùng biểu đồ tròn khi biểu đồ cột hoặc đường sẽ phù hợp hơn. Sử dụng màu kém, chẳng hạn thiếu độ tương phản, có thể khiến biểu đồ khó diễn giải. Cuối cùng, không cân nhắc mức độ chuyên môn của khán giả có thể dẫn đến truyền đạt sai, vì biểu đồ có thể quá phức tạp hoặc quá đơn giản.
Làm sao cải thiện khả năng kể chuyện với các biểu đồ?
Để nâng cao kể chuyện, hãy bắt đầu bằng việc tập trung vào một câu hỏi rõ ràng mà biểu đồ của bạn hướng tới trả lời. Đảm bảo làm nổi bật insight chính bằng màu sắc, kích thước hoặc chú thích để hướng sự chú ý của người xem. Sắp xếp các biểu đồ theo trình tự logic, dẫn dắt người xem qua dữ liệu để hé lộ insight từng bước, giúp mạch truyện tự nhiên hơn.
Khi nào tôi nên dùng trực quan hóa tương tác?
Trực quan hóa tương tác phù hợp khi xử lý bộ dữ liệu lớn khó hiển thị cùng lúc, cho phép người dùng lọc hoặc phóng to các điểm dữ liệu cụ thể. Chúng cũng hữu ích khi bạn có khán giả đa dạng, giúp các bên liên quan khác nhau khám phá insight phù hợp nhất với họ. Ngoài ra, chúng hữu ích trong bối cảnh ra quyết định, nơi các bên có thể tương tác với dữ liệu theo thời gian thực và khám phá nhiều kịch bản.
Làm sao chọn giữa công cụ không cần code và công cụ dựa trên code?
Các công cụ không cần code, như Power BI và Tableau, phù hợp cho những người cần biểu đồ nhanh, dễ tiếp cận mà không cần kỹ năng lập trình. Đây là lựa chọn tuyệt vời cho chuyên gia kinh doanh và quản lý. Công cụ dựa trên code, như Matplotlib của Python hoặc ggplot2 của R, cung cấp nhiều linh hoạt và tùy biến hơn cho người dùng thoải mái với lập trình. Chúng lý tưởng cho nhà khoa học dữ liệu hoặc nhà phân tích làm việc với dữ liệu phức tạp và cần toàn quyền kiểm soát quy trình trực quan hóa.
Làm thế nào để đảm bảo khả năng tiếp cận trong trực quan hóa dữ liệu?
Kết hợp bảng màu dễ phân biệt với nhãn, ký hiệu hoặc họa tiết để không truyền đạt thông tin chỉ bằng màu. Cung cấp mô tả ngắn cho hình ảnh và phần mô tả đầy đủ hoặc bảng dữ liệu khi biểu đồ chứa thông tin phức tạp. Với biểu đồ tương tác, bảo đảm các chức năng lọc, chọn và khám phá dữ liệu có thể sử dụng qua bàn phím, đồng thời có nhãn điều khiển rõ ràng.
Ứng dụng thực tế với STALI
Với chủ đề Trực quan hóa dữ liệu, hãy thử trên dữ liệu và tiêu chí thành công của chính bạn, gồm độ chính xác, độ trễ và tổng chi phí. Với dữ liệu tiếng Việt, nên thử thêm cách diễn đạt địa phương, tài liệu dài và yêu cầu định dạng đầu ra. Lưu lại cấu hình và kết quả để so sánh các phương án bằng cùng một phép thử.
Kiểm tra mô hình đang được hỗ trợ và mức phí hiện hành tại bảng giá STALI. Giá nhà cung cấp được phân tích trong bài là dữ kiện tham khảo, không thay thế giá bán và điều kiện sử dụng trên STALI.
Để triển khai, đọc tài liệu tích hợp API STALI, sau đó đăng ký tài khoản STALI để quản lý khóa API và sử dụng các mô hình có trong danh mục.
Đọc thêm các phân tích liên quan trên STALI: