Lập trình trong không gian trọng số (weight-space programming) là một phương pháp trong đó một mô hình ngôn ngữ lớn (LLM) đa dụng đọc các trọng số thô của một mạng nơ-ron và chỉnh sửa hoặc viết chúng trực tiếp từ một mục tiêu bằng ngôn ngữ tự nhiên, không cần hạ dốc gradient và không có vòng lặp huấn luyện. Trong một bài blog đăng ngày 2 tháng 11, 2026, bốn nhà nghiên cứu của MIT CSAIL báo cáo rằng GPT-6 Astra đã có thể làm điều này: nó chỉnh 0,016% trọng số của Qwen3.5-0.8B và nâng điểm MATH-500 của mô hình từ 7,9% lên 48,1%.
Nhóm tác giả gồm Rikiya Takehi, Jayden Teoh, Alex Zhang và Omar Khattab thuộc MIT CSAIL. Đây là kết quả sớm với một LLM; kho công khai lưu prompt, phản hồi và đánh giá của các lượt chạy được báo cáo, không bao gồm mọi thử nghiệm ban đầu hoặc toàn bộ hạ tầng thực nghiệm.
Bài viết này giải thích weight-space programming, tám thí nghiệm, các thất bại và những điểm người làm dữ liệu có thể tự kiểm tra. Các kết quả được ghi là báo cáo của nhóm nghiên cứu, không phải phép thử do STALI thực hiện.
Tóm tắt nhanh
- Là gì: Một LLM suy luận về trọng số của mạng và tự tay thay đổi chúng, thay vì một bộ tối ưu như Adam thay đổi thông qua gradient.
- Kết quả nổi bật: GPT-6 Astra lần theo các vòng lặp suy nghĩ của Qwen3.5-0.8B tới một hướng trong các trọng số và trừ nó đi, thu được lợi ích ở toán và tuân thủ hướng dẫn.
- Giới hạn chính: Các thí nghiệm minh họa khả năng gỡ một lỗi che khuất năng lực; chúng chưa chứng minh cách này bổ sung được năng lực mới hoặc khái quát sang mọi mô hình.
- Đã nên dùng chưa? Đây là hướng nghiên cứu để kiểm tra trong môi trường thử nghiệm. Có thể bắt đầu từ log của Thí nghiệm 1; ước tính dưới 1 USD chỉ đúng với lượng token và đơn giá API được nêu ở phần thực hành.
Weight-Space Programming là gì?
Weight-space programming là thực hành yêu cầu một LLM đọc, sửa hoặc viết trực tiếp các trọng số của một mạng nơ-ron dựa trên một đặc tả bằng ngôn ngữ tự nhiên, đôi khi không cần bất kỳ phản hồi nào từ môi trường. LLM tìm ra mỗi phần của mạng đang tính toán gì, hoặc nên tính toán gì, và đặt các con số tương ứng.
Đó là một lộ trình khác với cách trọng số thường được tạo ra. Hiện nay, trọng số đến từ hạ dốc gradient với các bộ tối ưu như Adam hoặc Muon, từ các mạng được huấn luyện để sinh trọng số của mạng khác, hoặc từ các trình biên dịch chuyển chương trình hình thức thành mạng. Trong thiết lập của MIT, GPT-6 Astra không viết vòng lặp huấn luyện. Nó suy luận về trọng số như cách một kỹ sư suy luận về mã nguồn.
LLM đã tối ưu hóa prompt, chương trình và mã huấn luyện. Lập luận của các tác giả là sự tối ưu hóa dựa trên suy luận này giờ đã chạm tới chính các trọng số.
Những gì các nhà nghiên cứu MIT đã báo cáo
8 thí nghiệm rơi vào ba nhóm: đọc trọng số, sửa chúng và viết từ đầu. Phần lớn dùng các mạng nhỏ có trọng số vừa với cửa sổ ngữ cảnh của Astra dưới dạng văn bản; các mạng lớn hơn bổ sung sandbox Python và một số có ngân sách cho các lượt truyền xuôi.
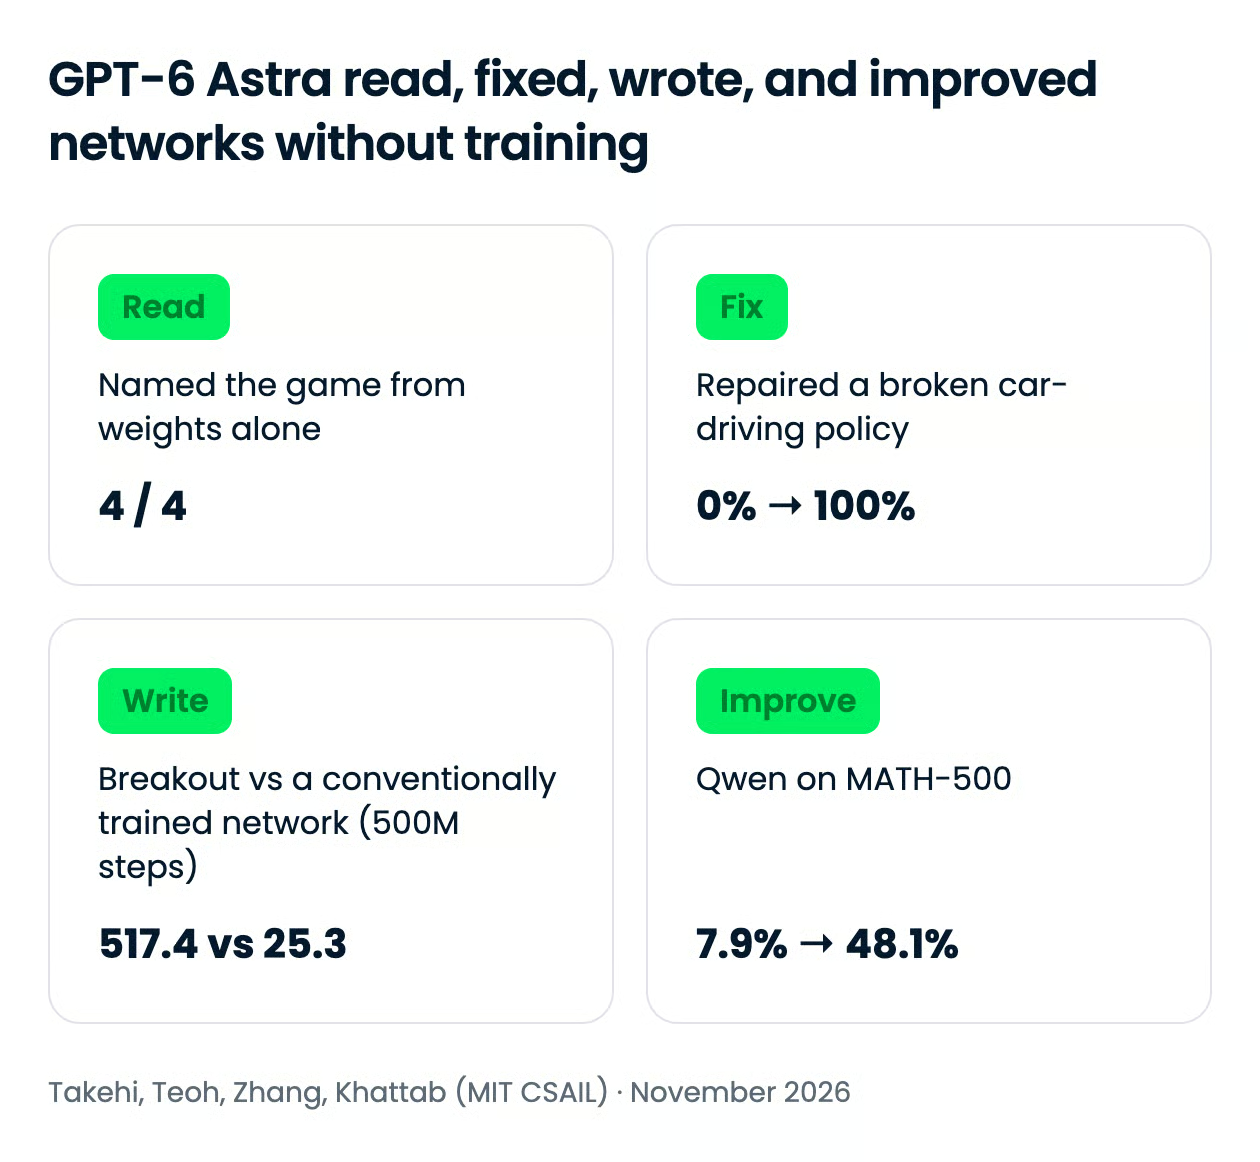
Tóm tắt số liệu do Takehi, Teoh, Zhang và Khattab (MIT CSAIL) công bố tháng 11/2026; không phải thử nghiệm do STALI thực hiện.
Đọc trọng số của một mạng
Nhóm đã huấn luyện bốn policy bằng proximal policy optimization (PPO), thuật toán học tăng cường chuẩn cho tác tử chơi game, trên các phiên bản lưới của Breakout, Pong, Pac-Man và Freeway, tất cả dùng cùng một kiến trúc có 17.253 trọng số. Mà không được cung cấp danh sách trò chơi, Astra đã gọi đúng tên trò chơi cho cả 4 mạng, đọc các manh mối như trọng số lớp đầu tiên của tác tử Breakout nằm dọc hàng dưới cùng, nơi có thanh trượt.
Hai phiên bản khó hơn theo sau:
- Mô hình khuếch tán: Từ trọng số của 3 DDPM nhỏ, không được phép truyền xuôi, Astra xác định cái nào sinh hình tròn, vuông hoặc tam giác. Nó vẽ các hình dạng như nét viền mặc dù các mô hình tạo hình đặc, một gợi ý rằng nó đọc hình học trọng số thay vì mô phỏng mạng.
- Mô hình ngôn ngữ: Chỉ được cung cấp 4 block transformer giữa của các mô hình ký tự khoảng 7,2 triệu tham số, Astra gọi tên ngôn ngữ huấn luyện — Python, tiếng Nhật romaji hoặc tiếng Anh — cho cả 3, trong cả hai lần thử. Theo nhóm tác giả, nó cũng xác định đúng các copying head (induction head) trong thiết lập này. Thí nghiệm cho dùng Python để phân tích trọng số nhưng cấm chạy mạng trên đầu vào.
Sửa một policy bị hỏng
Một policy PPO được huấn luyện 1 tỷ bước trên màn xe và dốc trong môi trường Kinetix luôn lái thẳng vào dốc và chết máy. Được cung cấp 171.664 trọng số, bối cảnh cảnh và một tập đã ghi, Astra giải thích nguyên nhân lỗi và viết một bản sửa trong một phản hồi duy nhất không cần công cụ. Bản chỉnh sửa thay đổi 3,5% trọng số và nâng tỷ lệ thành công từ 0% lên 100% trên 1.024 tập.
Bản sửa dễ đọc: một nhánh nhỏ bổ sung để lùi xe lại, rồi tắt khi xe vượt qua dải.
Viết mạng từ đầu
Với ba trò chơi MinAtar, Astra nhận luật chơi, mã nguồn và một mạng toàn số 0, rồi viết mọi trọng số dưới dạng văn bản trong một phản hồi, không cần dữ liệu, gradient hay công cụ. Cả ba mạng đều vượt các tác tử PPO được huấn luyện 100 triệu bước.
| Trò chơi | PPO, 100M bước | PPO, 500M bước | Astra, một lần viết |
|---|---|---|---|
| Breakout | 15,8 | 25,3 | 517,4 |
| Seaquest | 5,6 | 88,9 | 53,1 |
| Asterix | 25,8 | 55,2 | 53,2 |
Breakout là ngoại lệ vì Astra viết nó như một chương trình: lớp đầu tính nơi quả bóng sẽ rơi, lớp thứ hai đưa thanh trượt đến đó. Một mạng cờ vây 9x9 với 1.480.274 trọng số, được viết trong sandbox Python, đã vượt mạng PPO cùng kích thước được huấn luyện trên 20 triệu ván khi Astra có 50 lượt truyền xuôi để thử nghiệm đối chiếu.
Sửa các vòng lặp suy luận trong Qwen3.5-0.8B
Kết quả thực tiễn nhất nhắm vào một lỗi đã biết. Thẻ mô hình của chính Qwen cảnh báo rằng Qwen3.5-0.8B dễ mắc các vòng lặp suy nghĩ, và trong các thử nghiệm của MIT, 93,0% câu trả lời MATH-500 của nó chạy tới giới hạn 32.768 token. Làm việc trong một kernel Python với 50 lượt truyền xuôi trên bài tập luyện từ GSM8K và MATH, Astra lần theo các vòng lặp tới một hướng do các MLP của lớp 15 và 19 viết ra và trừ nó khỏi 64 cột đầu ra ở mỗi lớp.
| Chỉ tiêu | Bản gốc | Bản chỉnh với 50 lượt truyền xuôi |
|---|---|---|
| Vị trí trọng số được tác động | — | 131.072 vị trí, khoảng 0,016%; 130.188 giá trị thực đổi sau làm tròn bfloat16 |
| MATH-500 | 7,9% | 48,1% |
| GSM8K | 13,8% | 67,1% |
| IFEval | 21,0% | 62,3% |
| Câu trả lời chạm giới hạn token | 93,0% | 33,1% |
Thiết lập đánh giá công bố: bật suy luận, giới hạn 32.768 token; các tập huấn luyện GSM8K và MATH dùng làm bài luyện cho quá trình chỉnh, các điểm benchmark được báo cáo ở tập đánh giá.
Tỷ lệ câu trả lời chạm giới hạn token giảm xuống 33,1%; khả năng tuân thủ hướng dẫn cũng cải thiện. Với 10 hoặc 25 lượt truyền xuôi, vòng lặp vẫn còn phổ biến. Model card ghi nhận Ahsen Khaliq dựng lại checkpoint từ log và chạy MATH-500 đạt 51,0%: 500 bài, 4 mẫu mỗi bài. Lượt chạy lại dùng cùng giao thức lấy mẫu nhưng checkpoint đa phương thức đầy đủ, trong khi bài gốc dùng bản xuất chỉ văn bản; các tensor ngôn ngữ được báo cáo khớp hash. Đây là kết quả do bên tái lập công bố, STALI không chạy lại benchmark.
Nơi Weight-Space Programming chưa đáp ứng
Weight-space programming chưa đáp ứng ở những nơi vấn đề không phải là một lỗi đơn lẻ, cục bộ trong trọng số. Các tác giả báo cáo hai thất bại rõ ràng, và cả hai đều mang tính gợi mở.
- Nịnh bợ (sycophancy) không thấy rõ trong trọng số. Với một bản fine-tune trung thực và một bản nịnh bợ của Gemma 3 270M, Astra không thể phân biệt chúng chỉ từ trọng số trong cả bốn lần thử. Khi có thể xem mẫu chú ý, nó nhận ra bản nịnh bợ trong cả ba cặp.
- Gemma 3 270M không cải thiện toán đáng kể trong phép thử này. Mô hình gốc đạt 6,8% MATH-500; bản tốt nhất trong các ngân sách thử đạt 7,7%. Nhóm tác giả không xem mức tăng khoảng một điểm là cải thiện đã được xác lập. Kết quả gợi ý chỉnh trọng số có thể gỡ lỗi cục bộ, chưa chứng minh có thể tạo thêm năng lực toán mới.
Các lưu ý rộng hơn: mọi thí nghiệm dùng một LLM, mạng lớn nhất có 0,8 tỷ trọng số, và đây là bài blog với kết quả sớm, không phải bài báo bình duyệt. Các tác giả cho biết họ vẫn đang xây dựng một bộ chuẩn đánh giá cho nhiệm vụ.
Ý nghĩa với các chuyên gia dữ liệu và AI
Với người làm thực hành, weight-space programming hiện là một tín hiệu nghiên cứu, chưa phải công cụ. Hai phần của nó đáng theo dõi ngay bây giờ.
Thứ nhất là khả năng diễn giải. Các phương pháp quy gán như SHAP giải thích mô hình qua các đầu vào, và diễn giải cơ chế cần các công cụ xây riêng cho nhiệm vụ. Astra khôi phục các induction head với một phương pháp nhân ma trận đã biết mà các nhà nghiên cứu không hề nhắc đến. Nếu điều đó giữ vững trên các mô hình lớn hơn, "hỏi một mô hình tiên phong lớp này làm gì" sẽ trở thành bước đầu trước khi dùng công cụ nặng.
Thứ hai là sửa chữa có mục tiêu. Khi một mô hình nhỏ có lỗi hẹp như vòng lặp của Qwen, chỉnh trọng số là một hướng khác để khảo sát bên cạnh fine-tune. Trong bản 50 lượt truyền xuôi, phép chỉnh tác động 131.072 vị trí ở hai tensor; sau làm tròn bfloat16, 130.188 giá trị thực sự khác bản gốc. Phần còn lại được giữ theo diff công bố. Điều đó chưa chứng minh sẽ tránh quên thảm họa cho mọi nhiệm vụ. Kiểm toán backdoor và unlearning không dữ liệu vẫn là những hướng đề xuất cần đánh giá riêng.
Cách tự thử Weight-Space Programming
Có thể bắt đầu bằng việc đọc hoặc phát lại một thí nghiệm từ log đã công bố. Các log ghi model gpt-6-astra. OpenAI có trang model API cho tên này và AWS đã công bố cung cấp trên Amazon Bedrock; quyền truy cập, khu vực, cấu hình và chi phí cần kiểm tra trên tài khoản dùng để thử. Thí nghiệm 1 — nhận diện trò chơi từ trọng số policy — là điểm bắt đầu tương đối gọn.
-
Lấy log. Clone kho lm_understand-logs. Mỗi thư mục thí nghiệm có một README ánh xạ mọi con số trong bài viết tới tệp nó xuất phát.
-
Chọn một thí nghiệm không công cụ. Thí nghiệm 1, 2, 4 và 5 không cho Astra dùng công cụ. Ở Thí nghiệm 1, thư mục lượt chạy có prompt.txt chứa câu hỏi, mô tả mạng và 17.253 trọng số. Có thể dùng log để đối chiếu một phản hồi mới, nhưng một prompt không bảo đảm tái tạo đúng kết quả vì phiên bản model và tính ngẫu nhiên có thể khác.
-
Gửi theo cấu hình được ghi trong log. Tác giả dùng Codex CLI, codex exec, prompt qua stdin và tắt các công cụ tích hợp. Thí nghiệm 1 ghi effort high. harness/codex_config.toml đặt mặc định gpt-6-luna và medium, nên phải đối chiếu model/effort của từng run.json thay vì dùng mặc định đó cho mọi thí nghiệm. Không chạy mã lấy từ một log mà chưa đọc và kiểm tra nó.
-
So sánh câu trả lời. Mỗi thư mục lần chạy cũng giữ
answer.mdcủa Astra, vàeval/chứa việc chấm điểm và đáp án.
Ví dụ tính chi phí tại ngày 06/11/2026: đơn giá API Standard của gpt-6-astra là 10 USD/triệu token đầu vào và 50 USD/triệu token đầu ra. Nếu một lượt dùng 73.700 token đầu vào và dưới 2.000 token đầu ra được tính phí, phép tính là 0,737 USD + dưới 0,10 USD, tức dưới 0,837 USD. Phải tính đủ token suy luận được tính phí, các lượt tiếp theo, công cụ và hạ tầng; đây không phải giá STALI hoặc mức chi phí bảo đảm cho mọi lần chạy. Với các thí nghiệm dùng Python (3, 6, 7, 8), đọc README riêng: sandbox.py được công bố là phần minh họa cho thí nghiệm Go, còn README exp8_math nêu không kèm toàn bộ agent harness/forward-pass server. Clone kho logs chưa đủ để hứa chạy lại trọn vẹn mọi thí nghiệm.
Nếu không muốn gọi Astra, có thể đọc checkpoint Qwen3.5-0.8B đã chỉnh trên Hugging Face, được ghi giấy phép Apache-2.0, và đối chiếu SHA256 của hai tensor trong model card. Có một Hugging Face Space do bên thứ ba cung cấp để so sánh mô hình gốc và bản chỉnh; tình trạng chạy và kết quả của demo phụ thuộc dịch vụ đó. Kiểm tra cấu hình, tài nguyên và giấy phép khi tự tải/chạy; STALI chưa xác nhận kết quả bằng một lần chạy riêng.
Kết luận
Weight-space programming cho thấy một LLM có thể đọc và chỉnh trọng số bằng suy luận trong các mạng và lỗi được khảo sát. Bản sửa Qwen đáng chú ý vì có log, diff và một model card công bố lần chạy lại độc lập, thay vì chỉ có một con số tổng kết.
Tôi thận trọng hơn với các khẳng định lớn hơn. Một mô hình, các mạng nhỏ và chưa có bộ chuẩn là nền tảng mỏng cho cách đóng khung của các tác giả rằng "trọng số mạng nơ-ron của chúng ta sắp được LLM tối ưu trực tiếp". Dù vậy, các thất bại được báo cáo cẩn thận như các thành công, và điều đó khiến tôi coi trọng các thành công hơn.
Tài liệu để kiểm tra và áp dụng
Đối chiếu bài nghiên cứu của nhóm MIT CSAIL, kho log và giấy phép, README thí nghiệm chỉnh Qwen và model card và điều kiện tái lập. Giá và tên model API đối chiếu tài liệu model OpenAI; thông tin Bedrock theo thông báo AWS.
Với nhóm dữ liệu tại Việt Nam, có thể bắt đầu bằng việc so sánh prompt, cấu hình, diff tensor và bộ chấm có sẵn trên một bản sao riêng, ghi rõ phiên bản model, seed, token và ngân sách. Chỉ xem xét sử dụng sau khi đánh giá lại nhiều tác vụ, chất lượng ngoài bài toán mục tiêu và khả năng khôi phục checkpoint gốc. Không dùng một benchmark toán làm bằng chứng toàn diện cho ứng dụng thực tế.
Câu hỏi thường gặp
Weight-space programming là gì?
Weight-space programming là một phương pháp trong đó một LLM đa dụng đọc các trọng số thô của một mạng nơ-ron và chỉnh hoặc viết chúng trực tiếp từ một mục tiêu bằng ngôn ngữ tự nhiên, không cần hạ dốc gradient hay vòng lặp huấn luyện. Thuật ngữ này đến từ một bài blog tháng 11/2026 của các nhà nghiên cứu MIT CSAIL Rikiya Takehi, Jayden Teoh, Alex Zhang và Omar Khattab, những người đã thử nghiệm nó với GPT-6 Astra.
LLM có thể chỉnh trực tiếp trọng số mạng nơ-ron không?
Có trong những thiết lập đã được báo cáo: một policy điều khiển từ 0% lên 100% trên 1.024 tập đánh giá và Qwen giảm tỷ lệ chạm giới hạn token từ 93,0% còn 33,1%. Kết quả của một LLM trên số ít mạng chưa đủ để khái quát sang mọi mô hình.
GPT-6 Astra đã cải thiện Qwen3.5-0.8B mà không cần huấn luyện như thế nào?
Trong cấu hình 50 lượt truyền xuôi, Astra trừ một hướng khỏi 64 cột đầu ra của mỗi MLP ở lớp 15 và 19. Phép chỉnh tác động 131.072 vị trí; sau làm tròn bfloat16, 130.188 giá trị khác bản gốc. Nhóm báo cáo MATH-500 từ 7,9% lên 48,1%, GSM8K từ 13,8% lên 67,1% và IFEval từ 21,0% lên 62,3%.
Weight-space programming có thay thế cho fine-tune không?
Chưa có bằng chứng để coi đây là giải pháp thay thế fine-tune nói chung. Các thử nghiệm cho thấy có thể sửa một số lỗi cục bộ, trong khi thay đổi Gemma 3 270M chỉ tạo mức tăng nhỏ chưa được xác lập. Cần đánh giá riêng trên dữ liệu và nhiệm vụ mục tiêu.
Tôi có thể tự thử weight-space programming không?
Bạn có thể kiểm tra và thử nghiệm kết quả mà không cần truy cập GPT-6 Astra. Các nhà nghiên cứu đã công bố đầy đủ log thí nghiệm trên GitHub, bản Qwen3.5-0.8B đã chỉnh có trên Hugging Face theo Apache-2.0, và một Hugging Face Space cho phép bạn so sánh mô hình gốc và đã chỉnh trên bài toán của chính bạn.
Ứng dụng thực tế với STALI
Khi thử Weight-space programming, chọn một bộ tác vụ đại diện như đọc tài liệu tiếng Việt, sửa lỗi mã và trả kết quả theo JSON, rồi đối chiếu chất lượng với thời gian xử lý. Với tài liệu dài, kiểm tra khả năng trích đúng dữ kiện và dẫn lại vị trí trong văn bản. Ghi riêng token đầu vào, đầu ra và bộ nhớ đệm để ước tính chi phí theo khối lượng công việc thực tế.
Kiểm tra mô hình đang được hỗ trợ và mức phí hiện hành tại bảng giá STALI. Giá nhà cung cấp được phân tích trong bài là dữ kiện tham khảo, không thay thế giá bán và điều kiện sử dụng trên STALI.
Để triển khai, đọc tài liệu tích hợp API STALI, sau đó đăng ký tài khoản STALI để quản lý khóa API và sử dụng các mô hình có trong danh mục.
Đọc thêm các phân tích liên quan trên STALI: