Trong các nền tảng MLOps và hạ tầng có khả năng mở rộng, data lake là một thành phần quan trọng của ngăn xếp dữ liệu.
Không giống các kho dữ liệu truyền thống yêu cầu dữ liệu phải sạch và có cấu trúc trước khi lưu trữ, data lake cho phép bạn lưu mọi thứ ở dạng thô, lộn xộn và phi cấu trúc. Sự linh hoạt này mở ra vô vàn khả năng cho các ứng dụng và trường hợp sử dụng dựa trên dữ liệu. Data lake cho phép bạn thu thập và lưu trữ dữ liệu từ nhiều nguồn về một nơi, nơi dữ liệu có thể được phân tích sâu hơn và sử dụng cho AI.
Bài viết này giải thích data lake là gì, cách hoạt động, khi nào nên dùng và cách so sánh với các giải pháp truyền thống hơn.
Tìm hiểu khái niệm Data Lake
Trước khi bàn về kiến trúc kỹ thuật hay các trường hợp sử dụng, điều quan trọng là hiểu data lake là gì và điều gì khiến nó khác biệt với các hệ thống lưu trữ truyền thống hơn.
Phần này định nghĩa khái niệm, phân tích các đặc điểm chính và so sánh với thế giới có cấu trúc hơn của kho dữ liệu (data warehouse).
Định nghĩa data lake
Data lake là kho lưu trữ tập trung, chứa toàn bộ dữ liệu có cấu trúc, bán cấu trúc và phi cấu trúc của bạn ở mọi quy mô.
Bạn có thể nạp dữ liệu thô từ nhiều nguồn và giữ nguyên định dạng gốc cho đến khi cần xử lý hoặc phân tích.
Không giống cơ sở dữ liệu hoặc kho dữ liệu thường yêu cầu lược đồ được xác định trước (schema-on-write), data lake sử dụng cách tiếp cận schema-on-read. Điều này có nghĩa là cấu trúc chỉ được áp dụng khi dữ liệu được truy cập để phân tích, giúp các nhóm linh hoạt trong việc diễn giải và biến đổi dữ liệu về sau.
Các đặc điểm cốt lõi
Data lake có các đặc điểm cốt lõi sau:
- Khả năng mở rộng: Data lake được xây dựng để mở rộng theo chiều ngang. Dù bạn lưu trữ terabyte hay petabyte dữ liệu, các giải pháp lưu trữ đối tượng trên đám mây như Amazon S3 hoặc Azure Data Lake Storage giúp bạn phát triển dễ dàng mà không lo về dung lượng.
- Schema-on-read: Bạn không cần xác định lược đồ khi lưu trữ dữ liệu. Thay vào đó, nhà khoa học dữ liệu, nhà phân tích hoặc kỹ sư có thể áp dụng các lược đồ khác nhau tùy trường hợp sử dụng trong lúc truy xuất hoặc biến đổi.
- Lưu trữ dữ liệu thô: Data lake giữ lại mọi loại dữ liệu ở định dạng nguyên bản, dù là tệp CSV, log JSON, tệp âm thanh, video hay dữ liệu cảm biến.
- Hỗ trợ đa dạng loại dữ liệu: Bạn có thể lưu trữ dữ liệu có cấu trúc (ví dụ: bảng SQL), bán cấu trúc (ví dụ: XML, JSON) và phi cấu trúc (ví dụ: hình ảnh, PDF, văn bản) cùng một nơi.
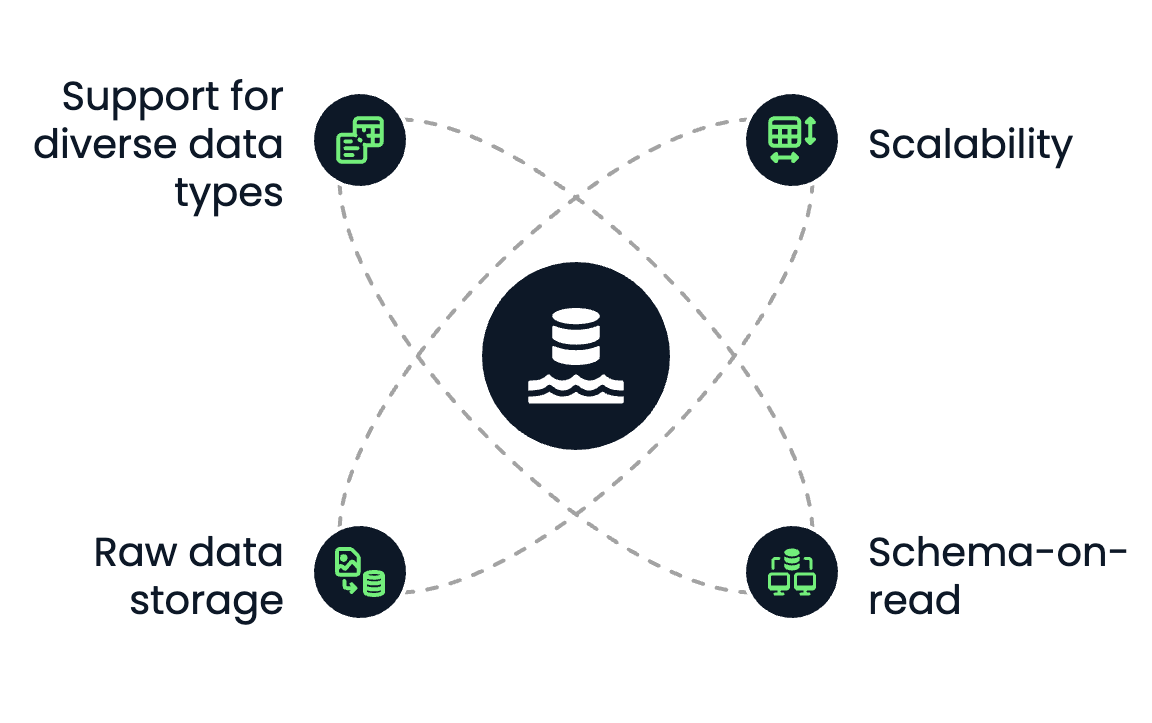
Các đặc điểm cốt lõi của data lake: hỗ trợ đa dạng dữ liệu, khả năng mở rộng, lưu trữ dữ liệu thô và schema-on-read.
So sánh với kho dữ liệu (data warehouse)
Data lake và data warehouse đều được dùng để lưu trữ và phân tích dữ liệu. Tuy nhiên, chúng khác nhau đáng kể về cấu trúc, hiệu năng và trường hợp sử dụng.
Tài liệu đọc thêm về data warehouse: Data Warehouse là gì và Kiến trúc Data Warehouse: Xu hướng, Công cụ và Kỹ thuật.
Bảng dưới đây mô tả các đặc điểm điển hình, đặc biệt với data warehouse truyền thống. Khả năng hỗ trợ dữ liệu và cách tổ chức lưu trữ có thể khác ở các nền tảng hiện đại.
|
Tính năng |
Data Lake |
Data Warehouse |
|
Loại dữ liệu |
Có cấu trúc, bán cấu trúc, phi cấu trúc |
Chủ yếu dữ liệu có cấu trúc; một số nền tảng hiện đại cũng hỗ trợ dữ liệu bán cấu trúc và phi cấu trúc |
|
Định dạng lưu trữ |
Thô (đối tượng tệp) |
Đã xử lý (bảng, hàng, cột) |
|
Lược đồ |
Schema-on-read |
Schema-on-write |
|
Chi phí |
Lưu trữ chi phí thấp |
Đắt hơn theo mỗi GB |
|
Trường hợp sử dụng |
Học máy, dữ liệu lớn và lưu trữ dữ liệu thô |
BI, phân tích dữ liệu có cấu trúc |
|
Hiệu năng |
Linh hoạt, phụ thuộc vào động cơ tính toán |
Tối ưu cho truy vấn SQL nhanh |
Trên thực tế, nhiều chiến lược dữ liệu hiện đại kết hợp cả hai: dùng data lake làm nền tảng lưu trữ dữ liệu thô và data warehouse cho báo cáo có cấu trúc và business intelligence.
Cũng có một giải pháp lai gọi là data lakehouse. Bài viết Data Lakehouse là gì? Kiến trúc, Công nghệ & Trường hợp sử dụng giải thích chi tiết hơn.
Các thành phần của Kiến trúc Data Lake
Một kiến trúc data lake được thiết kế tốt là điều cần thiết để biến dữ liệu thô thành dữ liệu có thể sử dụng và truy cập cho các tác vụ phân tích, học máy và báo cáo phía sau.
Phần này phân tích năm lớp chính của một data lake hiện đại, từ nạp dữ liệu đến quản trị.
Lớp nạp dữ liệu (ingestion)
Lớp nạp đưa dữ liệu từ nhiều nguồn vào data lake. Các nguồn này bao gồm hệ thống nội bộ (như cơ sở dữ liệu hoặc CRM), API bên ngoài, hoặc thiết bị IoT và log.
Có ba chế độ nạp chính:
- Nạp theo lô (batch): Tải dữ liệu định kỳ (như hằng đêm) theo từng lô.
- Nạp dòng (stream): Dòng dữ liệu thời gian thực, như clickstream hoặc dữ liệu cảm biến.
- Nạp lai (hybrid): Kết hợp cả batch và stream, thường thấy ở môi trường doanh nghiệp.
Các công cụ nạp dữ liệu tiêu chuẩn bao gồm:
- Apache Kafka và AWS Kinesis cho streaming
- Apache NiFi, Flume, và AWS Glue cho ETL theo lô
Một lớp nạp linh hoạt đảm bảo dữ liệu đến nhanh và có thể xử lý nhiều định dạng, tốc độ.
Lớp lưu trữ
Khi dữ liệu được nạp, nó được lưu ở vùng thô của data lake. Lớp lưu trữ thường dựa trên lưu trữ đối tượng đám mây, cung cấp khả năng mở rộng đàn hồi, dự phòng và hiệu quả chi phí.
Các lựa chọn phổ biến gồm:
- Amazon S3
- Azure Data Lake Storage
- Google Cloud Storage
Tuy nhiên, cũng có lựa chọn cho các công ty muốn lưu dữ liệu trong đám mây on-premise tại trung tâm dữ liệu của họ.
Ví dụ, có thể cài đặt MinIO trong hạ tầng của họ. Bản thân MinIO là mã nguồn mở và cung cấp API tương thích Amazon S3.
Các tính năng chính của lớp lưu trữ bao gồm:
- Độ bền và sẵn sàng cao: Dữ liệu được tự động nhân bản trên nhiều vùng.
- Tách biệt lưu trữ và tính toán: Bạn có thể mở rộng tài nguyên tính toán độc lập theo nhu cầu.
- Phân tầng dữ liệu: Cho phép lưu trữ lạnh cho lưu trữ dài hạn và lưu trữ nóng cho dữ liệu truy cập thường xuyên.
Lưu dữ liệu ở định dạng gốc cho phép bạn giữ trọn tiềm năng của nó cho xử lý và phân tích trong tương lai.
Danh mục và quản lý siêu dữ liệu
Không có siêu dữ liệu, data lake sẽ biến thành “đầm lầy dữ liệu” vì bạn không thể tìm lại dữ liệu và làm việc hiệu quả với nó.
Lớp danh mục và siêu dữ liệu mang lại cấu trúc cho sự hỗn độn bằng cách theo dõi:
- Lược đồ dữ liệu
- Vị trí và phân vùng dữ liệu
- Dòng dõi dữ liệu (lineage) và phiên bản hóa
Lớp này đảm bảo khả năng khám phá và sử dụng bằng cách lập chỉ mục mọi bộ dữ liệu sẵn có và cho phép tìm kiếm, kiểm soát truy cập. Các công cụ tiêu chuẩn cho lớp này gồm:
- AWS Glue Data Catalog
- Apache Hive Metastore
- Apache Atlas
- DataHub
Một hệ thống siêu dữ liệu vững chắc là thiết yếu cho cộng tác, quản trị và hiệu quả vận hành.
Lớp xử lý và phân tích
Đây là lớp nơi dữ liệu thô được xử lý và chuyển thành insight. Lớp xử lý hỗ trợ nhiều thao tác, từ biến đổi cơ bản đến phân tích nâng cao và học máy.
Quy trình điển hình bao gồm:
- Pipeline ETL/ELT để làm sạch và chuẩn hóa dữ liệu
- Truy vấn SQL
- Pipeline học máy
Lớp này thường bao gồm tính toán theo lô và thời gian thực, cho phép phân tích dữ liệu khám phá và khối lượng công việc sản xuất.
Bảo mật và quản trị
Một kiến trúc data lake vững chắc phải có cơ chế tích hợp để bảo vệ dữ liệu nhạy cảm và đảm bảo tuân thủ. Phần này rất quan trọng, vì data lake thường chứa nhiều dữ liệu nhạy cảm mà khi bị xâm phạm có thể gây hại cho doanh nghiệp sở hữu chúng.
Các tính năng thiết yếu của lớp này gồm:
- Quản lý danh tính và truy cập (IAM): Giới hạn ai có thể xem hoặc chỉnh sửa dữ liệu.
- Mã hóa: Mã hóa khi truyền (TLS) và khi lưu trữ.
- Che giấu và ẩn danh dữ liệu: Để xử lý thông tin nhận diện cá nhân.
- Kiểm toán và giám sát: Đảm bảo khả năng truy vết và tuân thủ.
Các công cụ và dịch vụ phổ biến:
- AWS Lake Formation
- Apache Ranger
- Azure Purview
Bảo mật thường quyết định việc data lake có thể được sử dụng trong các ngành được quản lý như tài chính, y tế hay quân sự hay không.
Các trường hợp sử dụng phổ biến của Data Lake
Data lake phù hợp với các trường hợp sử dụng cần quy mô, tính linh hoạt và đa dạng loại dữ liệu. Chúng đóng vai trò nền tảng cho các hoạt động và ứng dụng hiện đại dựa trên dữ liệu trong nhiều ngành.
Phần này, chúng ta sẽ khám phá một số trường hợp sử dụng phổ biến và có tác động lớn, nơi data lake đóng vai trò trung tâm.
Phân tích dữ liệu lớn (Big Data)
Một trong những mục đích nổi tiếng nhất của data lake là cho phép phân tích dữ liệu ở quy mô lớn.
Vì data lake có thể lưu dữ liệu ở dạng thô, các tổ chức không còn cần phải làm sạch hay cấu trúc hóa mọi tập dữ liệu trước khi phân tích. Điều này lý tưởng khi thu thập log, dữ liệu cảm biến hoặc clickstream — những dữ liệu quá lớn hoặc thay đổi quá nhanh đối với các hệ thống truyền thống.
Data lake cho phép bạn:
- Phân tích dữ liệu lịch sử song song với dữ liệu thời gian thực
- Chạy truy vấn tùy chỉnh trên tập dữ liệu quy mô petabyte
- Kích hoạt phân tích liên phòng ban với một nguồn sự thật duy nhất
Các công cụ như Amazon Athena hoặc Google BigQuery có thể truy vấn dữ liệu trực tiếp trong lake mà không cần các biến đổi phức tạp hoặc di chuyển dữ liệu đi nơi khác.
Học máy và AI
Data lake rất phù hợp cho quy trình học máy và AI.
Chúng cung cấp môi trường lý tưởng để:
- Lưu trữ bộ dữ liệu huấn luyện ở nhiều định dạng (ví dụ: CSV, Parquet, hình ảnh, v.v.)
- Giữ dữ liệu thô và do đó toàn diện hơn, cho phép linh hoạt hơn khi khám phá, thử nghiệm và lặp mô hình ML
- Vận hành các pipeline ML tự động lặp qua khối lượng dữ liệu khổng lồ
Thay vì giới hạn mô hình ở dữ liệu đã làm sạch sẵn từ kho dữ liệu, nhà khoa học dữ liệu có thể truy cập dữ liệu thô, phong phú để thử nghiệm tự do hơn và lặp nhanh hơn. Điều này đặc biệt hữu ích trong các lĩnh vực như xử lý ngôn ngữ tự nhiên (NLP), thị giác máy tính và dự báo chuỗi thời gian.
Có thể tìm hiểu cách sử dụng giải pháp Lakehouse của Databricks cho AI trong Hướng dẫn Toàn diện về Databricks Lakehouse AI cho Nhà khoa học Dữ liệu.
Lưu trữ tập trung và lưu trữ dài hạn
Nhiều tổ chức sử dụng data lake cho lưu trữ dài hạn và lưu trữ tập trung.
Nhờ chi phí thấp của lưu trữ đối tượng đám mây, việc lưu trữ nhiều năm dữ liệu vận hành trở nên khả thi về kinh tế, dù không dùng hằng ngày nhưng vẫn cần truy cập cho mục đích tuân thủ, kiểm toán, phân tích xu hướng, dự báo hoặc huấn luyện mô hình ML trong tương lai.
Hầu hết giải pháp lưu trữ đối tượng đám mây cho phép bạn phân tầng lưu trữ để lưu trữ dữ liệu ít truy cập, đồng thời giữ cho lake gọn nhẹ và hiệu quả.
Thử nghiệm khoa học dữ liệu
Data lake trao quyền cho nhà khoa học dữ liệu khám phá dữ liệu thô không bị ràng buộc.
Dù bạn đang xây dựng nguyên mẫu nhanh, kiểm thử giả thuyết mới hay thực hiện phân tích dữ liệu khám phá (EDA), lake cung cấp quyền truy cập linh hoạt tới:
- Dữ liệu thô phi cấu trúc (như PDF, email, tệp văn bản)
- Định dạng bán cấu trúc (như JSON, XML hoặc log)
- Tập dữ liệu khổng lồ không thể chứa trong CSDL truyền thống
Lớp thử nghiệm này rất quan trọng cho đổi mới. Data lake cho phép bạn khám phá bộ dữ liệu theo cách mới mà không cần gửi ticket cho đội kỹ thuật dữ liệu hay chờ phiên bản đã làm sạch trong kho dữ liệu.
Lợi ích và thách thức của Data Lake
Trong khi data lake cung cấp khả năng mạnh mẽ cho quy trình dữ liệu hiện đại, chúng cũng có những thách thức riêng. Hiểu cả hai mặt là điều thiết yếu trước khi áp dụng kiến trúc data lake. Phần này trình bày các lợi ích chính, cạm bẫy thường gặp và cách khắc phục.
Lợi ích của data lake
Ưu điểm lớn nhất của data lake là tính linh hoạt. Bạn không bị ràng buộc vào một lược đồ hoặc mô hình dữ liệu cụ thể ngay từ đầu, điều này rất tuyệt khi làm việc với tập dữ liệu thay đổi nhanh hoặc đang phát triển.
Dưới đây là một số lợi ích chính:
- Khả năng mở rộng: Data lake được xây dựng trên lưu trữ đám mây gốc có thể mở rộng dễ dàng, dù bạn lưu trữ gigabyte hay petabyte.
- Hỗ trợ mọi loại dữ liệu: Dữ liệu có cấu trúc (bảng SQL), bán cấu trúc (JSON, XML) và phi cấu trúc (văn bản, hình ảnh, video) đều có thể lưu trên cùng nền tảng.
- Hiệu quả chi phí: Lưu trữ đối tượng đám mây (ví dụ: Amazon S3) rẻ hơn đáng kể so với lưu trữ dùng trong CSDL hay kho dữ liệu truyền thống.
- Kiến trúc tách rời: Tính toán và lưu trữ được tách biệt để mở rộng khối lượng công việc phân tích độc lập với lưu trữ dữ liệu.
- Phân tích nâng cao: Data lake lưu dữ liệu thô, chưa xử lý và cho phép phân tích toàn diện, linh hoạt hơn, bao gồm học máy và phân tích dự đoán.
- Cải thiện ra quyết định: Data lake có thể cho phép phân tích sâu và toàn diện hơn, dẫn đến quyết định sáng suốt hơn trên toàn tổ chức.
- Xóa bỏ silo dữ liệu: Data lake giúp hợp nhất dữ liệu từ nhiều nguồn vào một kho tập trung, phá vỡ các silo dữ liệu.
Việc tập trung hóa dữ liệu có thể giảm silo dữ liệu và cải thiện cộng tác liên nhóm.
Thách thức chính
Data lake rất mạnh mẽ, nhưng cũng có một số thách thức cần quản lý. Nếu không, chúng có thể nhanh chóng trở nên hỗn độn và không dùng được, thường được gọi là “đầm lầy dữ liệu”.
Một số thách thức phổ biến gồm:
- Thiếu cấu trúc: Không có lược đồ định sẵn, dữ liệu có thể khó truy vấn, ghi chép hoặc quản trị.
- Vấn đề chất lượng dữ liệu: Vì dữ liệu được nạp ở dạng thô, dữ liệu kém chất lượng hoặc không đầy đủ có thể không bị phát hiện cho đến các bước sau.
- Khoảng trống siêu dữ liệu và khả năng khám phá: Không có hệ thống lập danh mục mạnh, người dùng có thể không biết có những dữ liệu nào hoặc cách sử dụng.
- Quản trị phức tạp: Đảm bảo kiểm soát truy cập, khả năng kiểm toán và tuân thủ khó khăn hơn trong môi trường linh hoạt.
Những vấn đề này có thể làm giảm niềm tin vào data lake và kìm hãm việc áp dụng trên toàn doanh nghiệp.
Cách giảm thiểu thách thức
Những data lake thành công nhất đều có thực hành quản lý siêu dữ liệu và vòng đời mạnh mẽ.
Đây là cách giảm rủi ro và giữ cho data lake “khỏe mạnh”:
- Triển khai danh mục dữ liệu: Các công cụ như AWS Glue hoặc DataHub giúp duy trì khả năng khám phá, định nghĩa lược đồ và theo dõi lineage.
- Dùng quy ước đặt tên và cấu trúc thư mục tiêu chuẩn: Tạo tính nhất quán và giảm nhầm lẫn cho đội ngũ.
- Áp dụng công cụ kiểm định và lập hồ sơ dữ liệu: Đảm bảo chất lượng trong lúc nạp và định kỳ tái kiểm định dữ liệu.
- Tự động hóa chính sách vòng đời: Tự động chuyển dữ liệu cũ sang lưu trữ lạnh hoặc xóa sau thời hạn lưu giữ xác định.
- Áp dụng kiểm soát truy cập và mã hóa mạnh: Để bảo vệ dữ liệu nhạy cảm, sử dụng chính sách IAM, truy cập theo vai trò và mã hóa khi lưu trữ lẫn khi truyền.
Data lake có thể vẫn là tài sản chứ không phải gánh nặng nếu thiết kế kiến trúc sạch ngay từ đầu và thiết lập cấu trúc quản trị vững chắc.
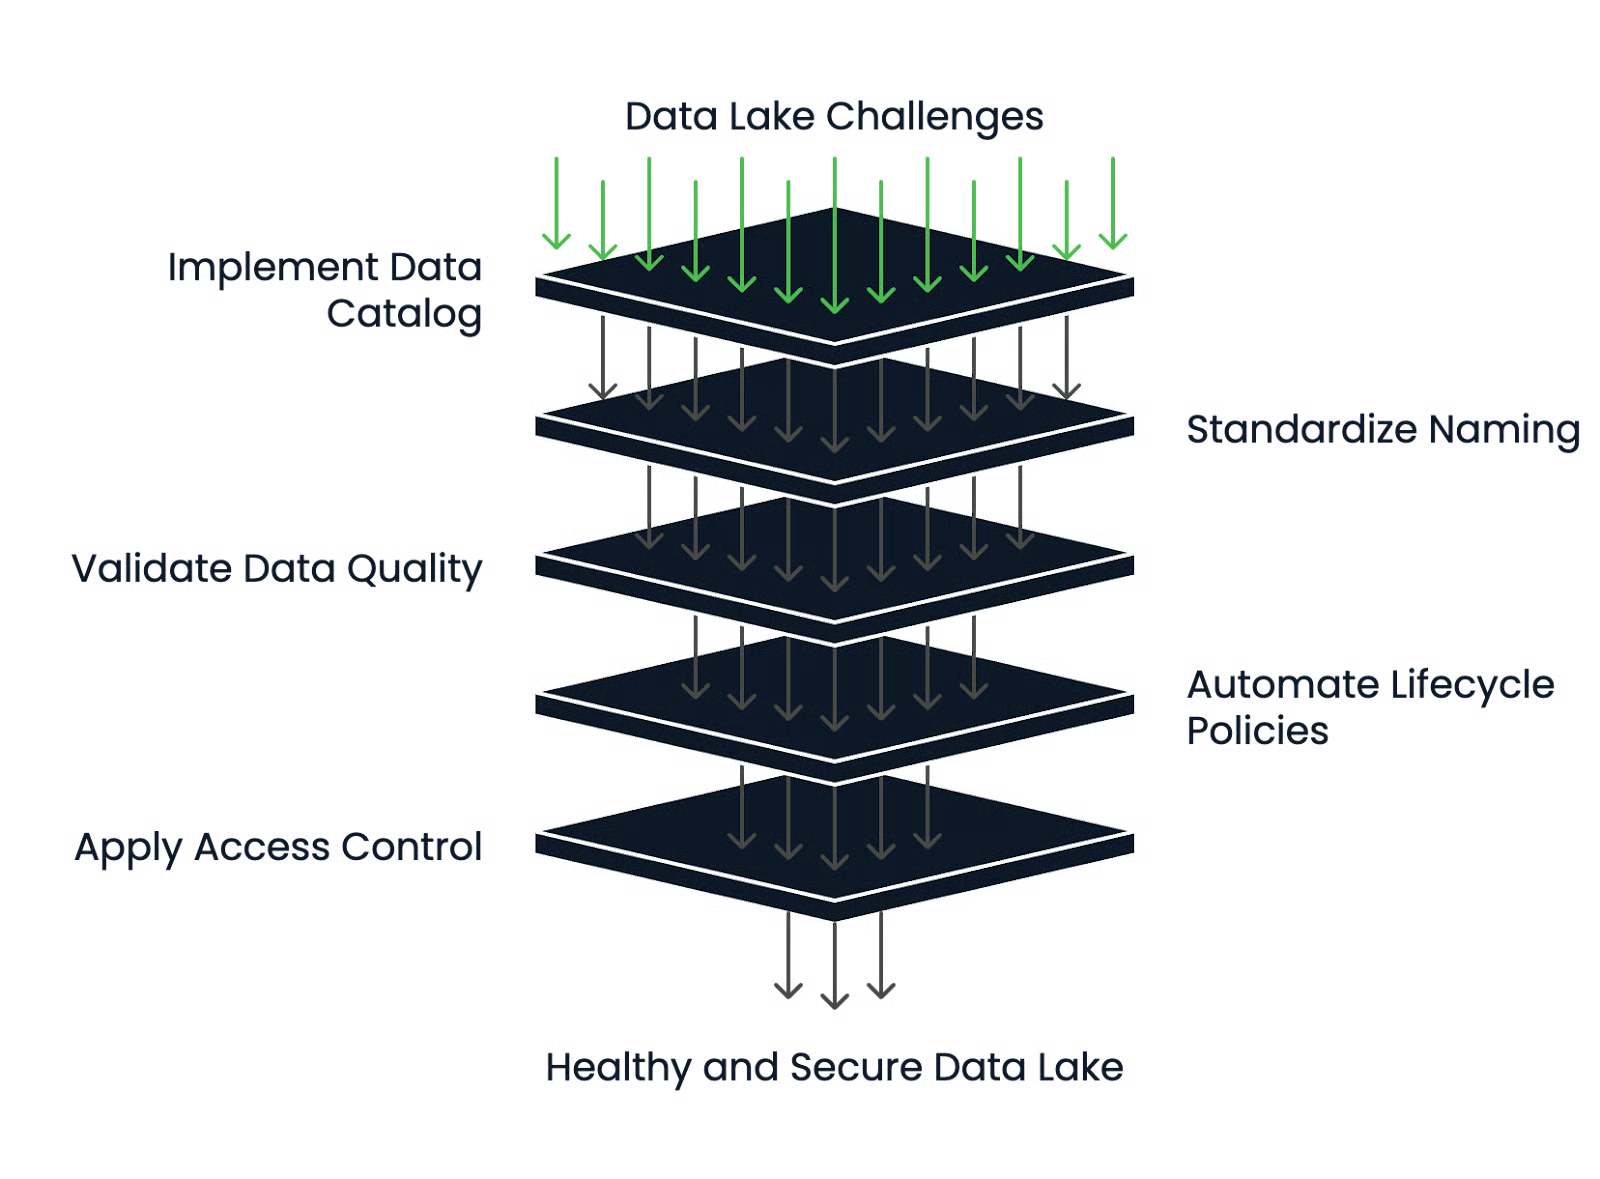
Khung quản lý sức khỏe data lake: lập danh mục, chuẩn hóa tên, kiểm định chất lượng, tự động hóa vòng đời và kiểm soát truy cập.
Các công nghệ Data Lake phổ biến
Với tầm quan trọng ngày càng tăng của data lake trong kiến trúc dữ liệu hiện đại, nhiều công nghệ đã xuất hiện để hỗ trợ. Các công cụ này trải dài từ nền tảng đám mây gốc, hệ sinh thái mã nguồn mở đến tích hợp với các giải pháp phân tích. Phần này giới thiệu các công cụ phổ biến nhất.
Giải pháp đám mây gốc
Nhà cung cấp đám mây cung cấp dịch vụ quản lý toàn diện để xây dựng và vận hành data lake. Các nền tảng này thường là điểm khởi đầu cho các nhóm tìm kiếm khả năng mở rộng, độ bền và tích hợp chặt với dịch vụ đám mây khác.
Các giải pháp đám mây gốc phổ biến gồm:
- Amazon S3 + AWS Lake Formation: S3 cung cấp lưu trữ đối tượng, trong khi Lake Formation xử lý phân quyền, lập danh mục và quản trị.
- Azure Data Lake Storage: Kết hợp lưu trữ blob với khả năng tương tự HDFS.
- Google Cloud Storage (GCS): GCS có độ bền cao và tích hợp tốt với BigQuery và Vertex AI cho khối lượng công việc phân tích và ML.
Các dịch vụ này được tối ưu cho khả năng đàn hồi, hiệu quả chi phí và bảo mật, rất phù hợp cho data lake quy mô doanh nghiệp.
Công cụ mã nguồn mở
Công nghệ mã nguồn mở tăng tính linh hoạt và khả năng mở rộng, đặc biệt cho các nhóm muốn tránh khóa nhà cung cấp hoặc vận hành trong môi trường lai/đa đám mây.
Các giải pháp phổ biến gồm:
- Apache Hadoop: Một trong những khung data lake đầu tiên. Dù ít phổ biến hơn với dự án mới hiện nay, nó đặt nền tảng cho lưu trữ và xử lý dữ liệu phân tán.
- Delta Lake: Do Databricks phát triển, Delta Lake bổ sung giao dịch ACID, phiên bản hóa và cưỡng chế lược đồ cho lưu trữ đối tượng đám mây.
- Apache Iceberg: Iceberg cung cấp thao tác nguyên tử, phân vùng ẩn và “du hành thời gian” để truy vấn dữ liệu lịch sử.
- Presto: Công cụ truy vấn SQL phân tán cho phép chạy truy vấn nhanh, tương tác trên dữ liệu lưu trong S3, HDFS hoặc nguồn khác mà không cần di chuyển dữ liệu.
Các công cụ này thường tích hợp vào nền tảng dữ liệu rộng hơn và được ưa chuộng bởi các đội kỹ thuật xây dựng giải pháp tùy biến hoặc theo mô-đun.
Đọc thêm về các tính năng, khác biệt và trường hợp sử dụng của Apache Iceberg và Delta Lake.
Tích hợp với nền tảng phân tích
Data lake trở nên giá trị khi được tích hợp với công cụ phân tích và trực quan hóa giúp khai thác insight và thúc đẩy quyết định kinh doanh. Vì vậy, trước khi chọn giải pháp cuối cùng, bạn luôn nên kiểm tra trước data lake cần tích hợp với các nền tảng phân tích nào.
Các nền tảng phân tích phổ biến gồm:
- Databricks: Kết hợp lưu trữ data lake với không gian làm việc cộng tác cho kỹ thuật dữ liệu, học máy và phân tích. Nó hỗ trợ Delta Lake ngay từ đầu.
- Snowflake: Nền tảng này hỗ trợ phân tích dữ liệu có cấu trúc và bán cấu trúc. Bảng ngoài (external table) cho phép truy vấn dữ liệu ở external stage trên lưu trữ đám mây mà không nạp dữ liệu đó vào bảng Snowflake. Snowpipe phục vụ nạp dữ liệu từ tệp vào bảng để sau đó truy vấn; đây là luồng nạp dữ liệu, không phải cơ chế truy vấn trực tiếp dữ liệu ngoài. Những khả năng này cho phép kết hợp kho dữ liệu với dữ liệu lưu trong lake tùy kiến trúc triển khai.
- Power BI, Tableau: Các công cụ BI này có thể kết nối tới data lake trực tiếp hoặc thông qua các động cơ truy vấn như Athena hoặc BigQuery, cho phép tạo dashboard và báo cáo trên dữ liệu thô hoặc bán cấu trúc.
Khi lựa chọn công nghệ, điều quan trọng là căn chỉnh với chuyên môn của đội ngũ, chiến lược dữ liệu của bạn và mức độ linh hoạt hay trừu tượng bạn cần.
Kết luận
Data lake trao quyền cho các tổ chức xây dựng ứng dụng học máy mạnh mẽ và dashboard thời gian thực bằng cách cung cấp nền tảng dữ liệu thô và bán cấu trúc linh hoạt, có thể mở rộng.
Trong bài viết này, chúng ta đã tìm hiểu data lake là gì, các thành phần chính và khi nào nên dùng. Chúng ta đã thảo luận lợi ích như tính linh hoạt và khả năng mở rộng, các thách thức như quản trị dữ liệu và nguy cơ “đầm lầy dữ liệu”, cùng cách tránh chúng. Cuối cùng, chúng ta đề cập các công nghệ phổ biến để xây dựng data lake, bao gồm nền tảng đám mây và công cụ mã nguồn mở.
Một data lake được kiến trúc tốt có thể hỗ trợ cách các đội ngũ cộng tác và đổi mới trong MLOps, hạ tầng AI và hệ thống dữ liệu gốc đám mây. Ngược lại, một data lake bị quản trị kém có thể trở thành gánh nặng và gây khó khăn khi tìm kiếm, sử dụng dữ liệu.
Nếu tổ chức của bạn xử lý dữ liệu phức tạp, đa dạng hoặc quy mô lớn và muốn kích hoạt thử nghiệm nhanh hơn, phân tích phong phú hơn hoặc phát triển AI, data lake có thể chính là điều bạn cần.
Câu hỏi thường gặp
Những loại tổ chức nào hưởng lợi nhiều nhất từ việc sử dụng data lake?
Các tổ chức xử lý tập dữ liệu quy mô lớn, đa dạng hoặc thay đổi nhanh, như công ty công nghệ, tổ chức tài chính và nhà cung cấp dịch vụ chăm sóc sức khỏe, là những đối tượng hưởng lợi nhiều nhất từ data lake.
Data lake hỗ trợ phân tích thời gian thực như thế nào?
Data lake có thể nạp dữ liệu streaming từ thiết bị IoT hoặc ứng dụng trong thời gian thực, cho phép phân tích tức thì và ra quyết định nhanh hơn thông qua các công cụ như Apache Kafka và Amazon Kinesis.
Data lake có thể triển khai on-premise hay chỉ trên đám mây?
Dù data lake dựa trên đám mây là phổ biến, vẫn có thể triển khai data lake on-premise bằng các giải pháp như Hadoop Distributed File System (HDFS) hoặc MinIO cho lưu trữ đối tượng tương thích S3.
Đầm lầy dữ liệu (data swamp) là gì và làm sao tránh được?
“Đầm lầy dữ liệu” xảy ra khi data lake trở nên hỗn độn và không thể sử dụng do quản lý siêu dữ liệu và quản trị kém. Lập danh mục, tài liệu hóa và chính sách quản trị mạnh giúp ngăn chặn điều này.
Data lake hỗ trợ phát triển học máy như thế nào?
Bằng cách lưu trữ dữ liệu thô và đa dạng, data lake cho phép nhà khoa học dữ liệu thử nghiệm tự do hơn, tạo bộ dữ liệu huấn luyện phong phú và lặp nhanh hơn trên các mô hình học máy.
Có những mối quan ngại tuân thủ nào cụ thể với data lake không?
Có, việc lưu dữ liệu phi cấu trúc và nhạy cảm ở dạng thô đòi hỏi các khung mã hóa, kiểm soát truy cập, kiểm toán và tuân thủ nghiêm ngặt để đáp ứng các quy định như GDPR và HIPAA.
Schema-on-read ảnh hưởng thế nào đến phân tích dữ liệu trong data lake?
Schema-on-read cho phép người dùng áp dụng các lược đồ khác nhau tại thời điểm truy vấn, mang lại sự linh hoạt nhưng cũng đòi hỏi khám phá và diễn giải dữ liệu cẩn thận để phân tích chính xác.
Sự khác nhau giữa data lake và data lakehouse là gì?
Data lakehouse kết hợp tính linh hoạt của data lake với khả năng quản lý và giao dịch của data warehouse, mang lại những gì tốt nhất của cả hai cho phân tích và AI.
Duy trì một data lake trên đám mây thường tốn bao nhiêu chi phí?
Chi phí thay đổi tùy theo dung lượng lưu trữ, truyền dữ liệu và tần suất truy cập, nhưng dịch vụ lưu trữ đối tượng đám mây (như Amazon S3) thường rẻ hơn mỗi GB so với cơ sở dữ liệu truyền thống.
Cần những kỹ năng nào để xây dựng và quản lý data lake thành công?
Các kỹ năng chính bao gồm quản lý hạ tầng đám mây, kỹ thuật dữ liệu, chuyên môn bảo mật và tuân thủ, quản lý siêu dữ liệu, và kinh nghiệm với công cụ dữ liệu lớn như Spark hoặc Presto.
Ứng dụng thực tế với STALI
Với chủ đề Data lake là gì? Kiến trúc, lợi ích và cách triển khai, hãy thử trên dữ liệu và tiêu chí thành công của chính bạn, gồm độ chính xác, độ trễ và tổng chi phí. Với dữ liệu tiếng Việt, nên thử thêm cách diễn đạt địa phương, tài liệu dài và yêu cầu định dạng đầu ra. Lưu lại cấu hình và kết quả để so sánh các phương án bằng cùng một phép thử.
Kiểm tra mô hình đang được hỗ trợ và mức phí hiện hành tại bảng giá STALI. Giá nhà cung cấp được phân tích trong bài là dữ kiện tham khảo, không thay thế giá bán và điều kiện sử dụng trên STALI.
Để triển khai, đọc tài liệu tích hợp API STALI, sau đó đăng ký tài khoản STALI để quản lý khóa API và sử dụng các mô hình có trong danh mục.
Đọc thêm các phân tích liên quan trên STALI: