Nếu bạn làm việc với kho dữ liệu, bạn sẽ biết việc tổ chức dữ liệu sao cho hiệu quả và dễ xử lý quan trọng thế nào. Nhưng bạn đã bao giờ nghĩ về việc schema cơ sở dữ liệu nào phù hợp nhất với nhu cầu của mình chưa? Có hai khung chính bạn có thể dùng cho mục đích này: star schema và snowflake schema.
Star schema tổ chức dimension gọn, dễ dùng cho phân tích; snowflake schema chuẩn hóa dimension thành nhiều bảng liên quan. Lựa chọn cần cân nhắc truy vấn, tính nhất quán, dung lượng và cách tối ưu của nền tảng thay vì mặc định một mẫu luôn nhanh hơn.
Trong bài viết này, tôi sẽ giới thiệu cấu trúc của các schema này, làm nổi bật sự khác biệt của chúng và phân tích ưu điểm. Đến cuối bài, bạn sẽ biết mỗi schema phù hợp ở đâu và cách quyết định cái nào tốt nhất cho dự án dữ liệu của bạn.
Star Schema là gì?
Star schema là cách tổ chức dữ liệu, đặc biệt trong kho dữ liệu, với bảng fact lưu các quan sát hoặc sự kiện ở mức chi tiết được xác định rõ. Các bảng dimension mô tả sản phẩm, khách hàng, ngày tháng hoặc các thực thể liên quan. Ví dụ đơn giản có một bảng fact ở trung tâm; hệ thống thực tế có thể có nhiều bảng fact dùng chung dimension.
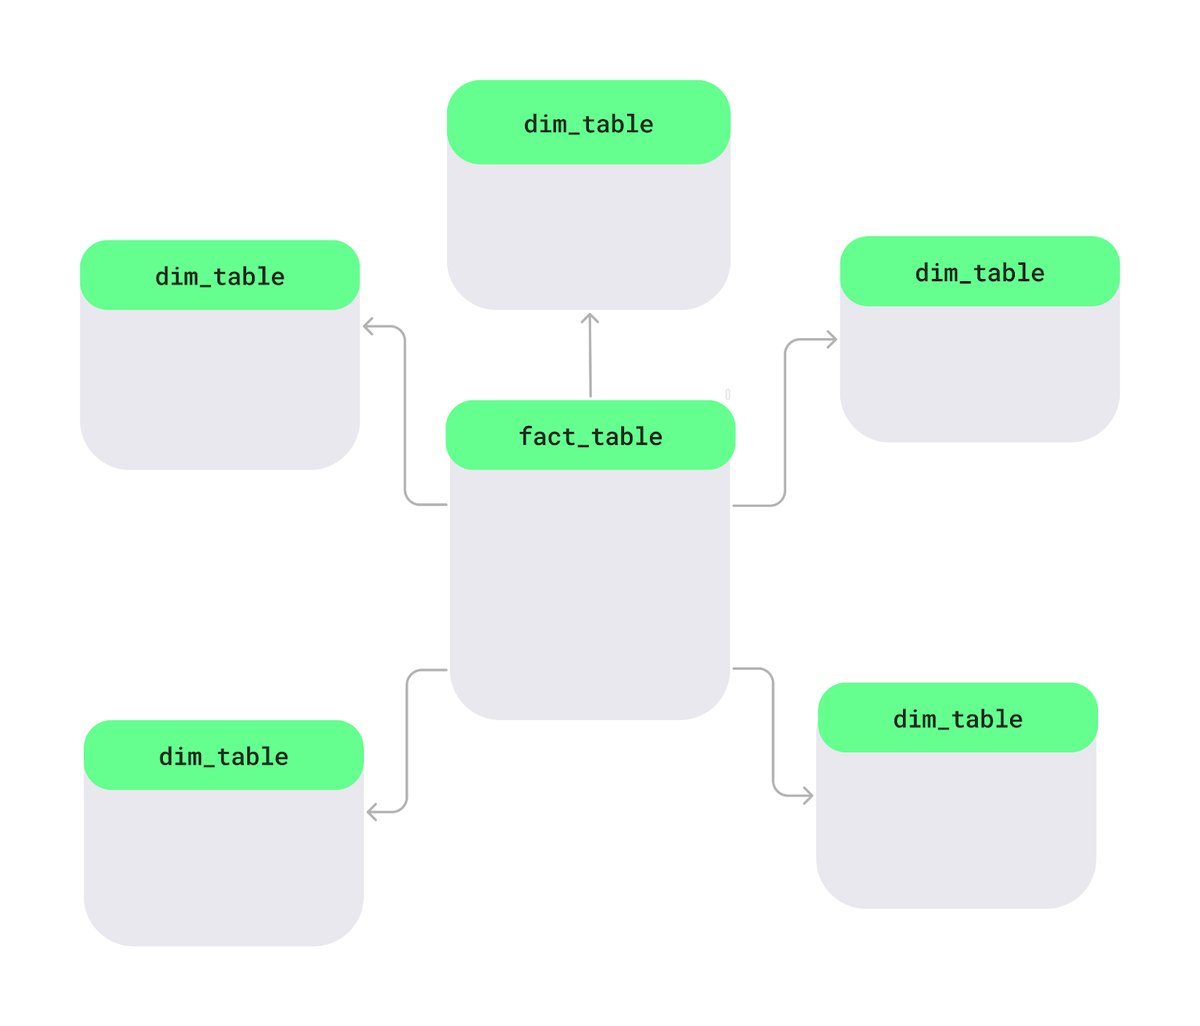
Bố cục star schema. Ảnh: Tác giả.
Hãy cùng xem các đặc điểm chính của star schema:
- Bảng dimension một cấp: Các bảng dimension kết nối trực tiếp với bảng fact mà không có các tầng bổ sung. Mỗi bảng tập trung vào một lĩnh vực như sản phẩm, khu vực hoặc thời gian, giúp dễ sử dụng.
- Thiết kế dimension phi chuẩn hóa: Một bảng sản phẩm có thể chứa cả ID, tên và danh mục. Tên danh mục có thể lặp giữa các sản phẩm; đổi lại, truy vấn ít phải đi qua các bảng phân cấp.
- Phổ biến trong kho dữ liệu: Star schema được dùng cho phân tích nhanh. Nó dễ dàng lọc hoặc tính tổng, nên thường là lựa chọn tốt cho kho dữ liệu nơi cần insight nhanh.
Hãy hiểu rõ hơn qua một sơ đồ star schema đơn giản. Bảng fact Sales nằm ở trung tâm. Nó chứa dữ liệu số bạn muốn phân tích, như doanh số hoặc lợi nhuận. Kết nối với nó là các bảng dimension với thông tin mô tả, như tên sản phẩm, vị trí khách hàng hoặc ngày tháng:
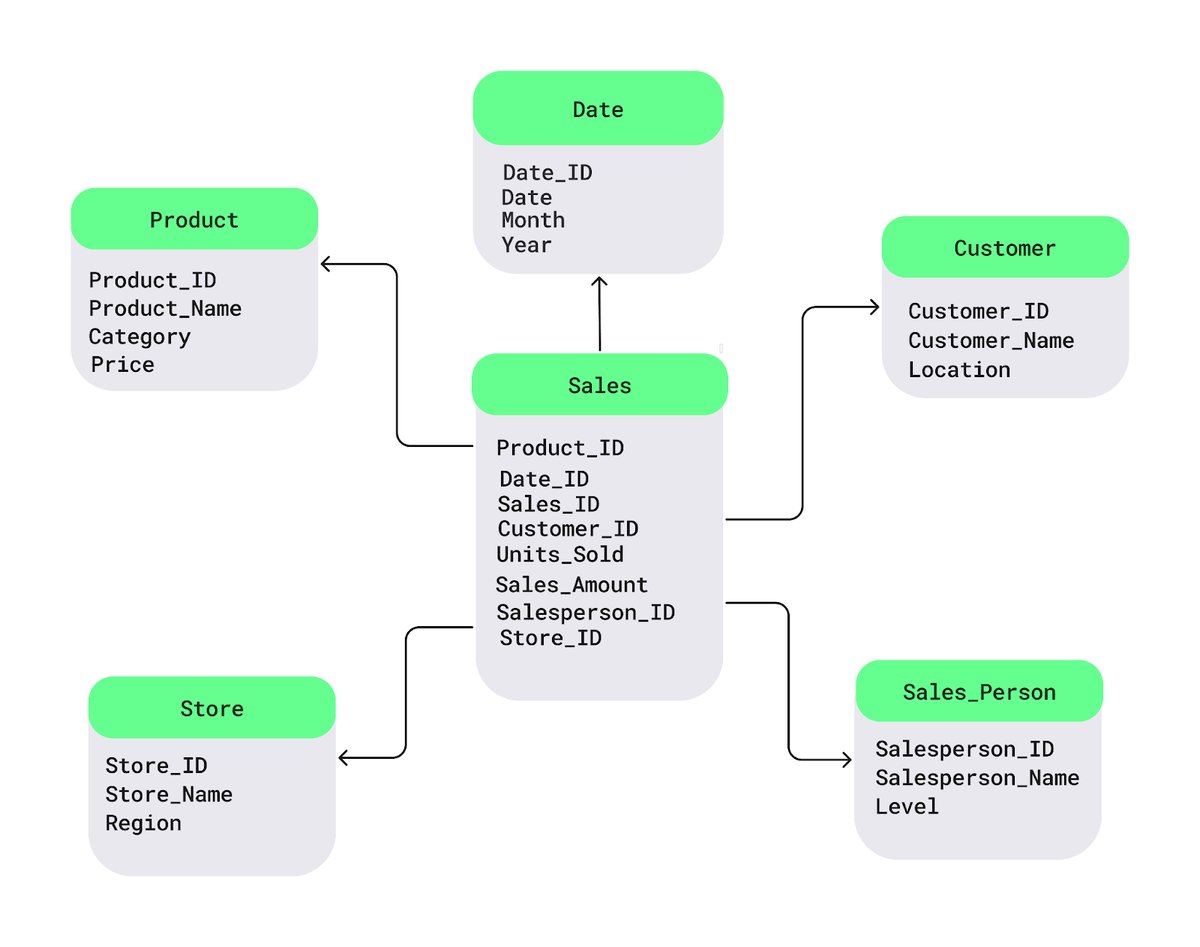
Ví dụ star schema mở rộng. Bản SQL dưới đây chỉ minh họa một tập con gồm Product, Customer, Date và Sales; không triển khai toàn bộ các cột và dimension trong sơ đồ.
Ví dụ SQL dưới đây giữ tên bảng của ví dụ, tạo dimension trước bảng fact và khai báo khóa ngoại nhất quán. Chạy hai thiết kế ở hai cơ sở dữ liệu thử nghiệm riêng; không tạo đè các bảng Sales/Product cùng tên. Mỗi hàng Sales đại diện một bản ghi bán hàng, phân biệt bằng Sales_ID.
-- Tạo dimension trước bảng fact
CREATE TABLE Product (
    Product_ID INT PRIMARY KEY,
    Product_Name VARCHAR(100),
    Category VARCHAR(50)
);

CREATE TABLE Customer (
    Customer_ID INT PRIMARY KEY,
    Customer_Name VARCHAR(100),
    Location VARCHAR(50)
);

CREATE TABLE "Date" (
    Date_ID INT PRIMARY KEY,
    "Date" DATE,
    Year INT,
    Month VARCHAR(20)
);

CREATE TABLE Sales (
    Sales_ID INT PRIMARY KEY,
    Product_ID INT,
    Customer_ID INT,
    Date_ID INT,
    Sales_Amount DECIMAL(10, 2),
    FOREIGN KEY (Product_ID) REFERENCES Product(Product_ID),
    FOREIGN KEY (Customer_ID) REFERENCES Customer(Customer_ID),
    FOREIGN KEY (Date_ID) REFERENCES "Date"(Date_ID)
);
Star schema làm rõ đường nối giữa fact và dimension. Truy vấn sau tính tổng doanh số theo vị trí khách hàng; tốc độ thực tế phụ thuộc dữ liệu, bộ tối ưu, lưu trữ và cấu hình:
SELECT c.Location, SUM(s.Sales_Amount) AS TotalSales
FROM Sales s
JOIN Customer c ON s.Customer_ID = c.Customer_ID
GROUP BY c.Location;
Tuy nhiên, bạn sẽ phải chấp nhận một số dư thừa dữ liệu vì các bảng dimension có thể chứa thông tin lặp lại.
Ưu điểm và hạn chế của star schema
Giờ bạn đã biết star schema là gì, hãy xem vì sao nó nổi bật:
- Hiệu năng truy vấn: Ít bước nối dimension có thể giúp tối ưu các truy vấn phân tích. Cần đo trên truy vấn và dữ liệu thực tế để xác định lợi ích, thay vì coi số phép nối là thước đo duy nhất.
- Dễ hiểu: Cấu trúc của nó hợp lý và đơn giản để hiểu, ngay cả với người không chuyên kỹ thuật. Thành viên mới có thể nhanh chóng nắm được bảng nào chứa dữ liệu họ cần, đẩy nhanh phân tích và đơn giản hóa bảo trì.
Dù có nhiều lợi ích, star schema vẫn có một nhược điểm. Như tôi đã đề cập, do phi chuẩn hoá, các bảng dimension thường chứa thông tin lặp lại, điều này làm tăng mức sử dụng lưu trữ. Ví dụ, nếu nhiều sản phẩm thuộc cùng một danh mục, tên danh mục có thể lặp lại cho mỗi sản phẩm, chiếm thêm dung lượng.
Snowflake Schema là gì?
Snowflake schema là một cách khác để tổ chức dữ liệu. Trong schema này, các bảng dimension được tách thành các bảng phân dimension nhỏ hơn để dữ liệu được tổ chức và chi tiết hơn — giống như những bông tuyết trong một hồ lớn.
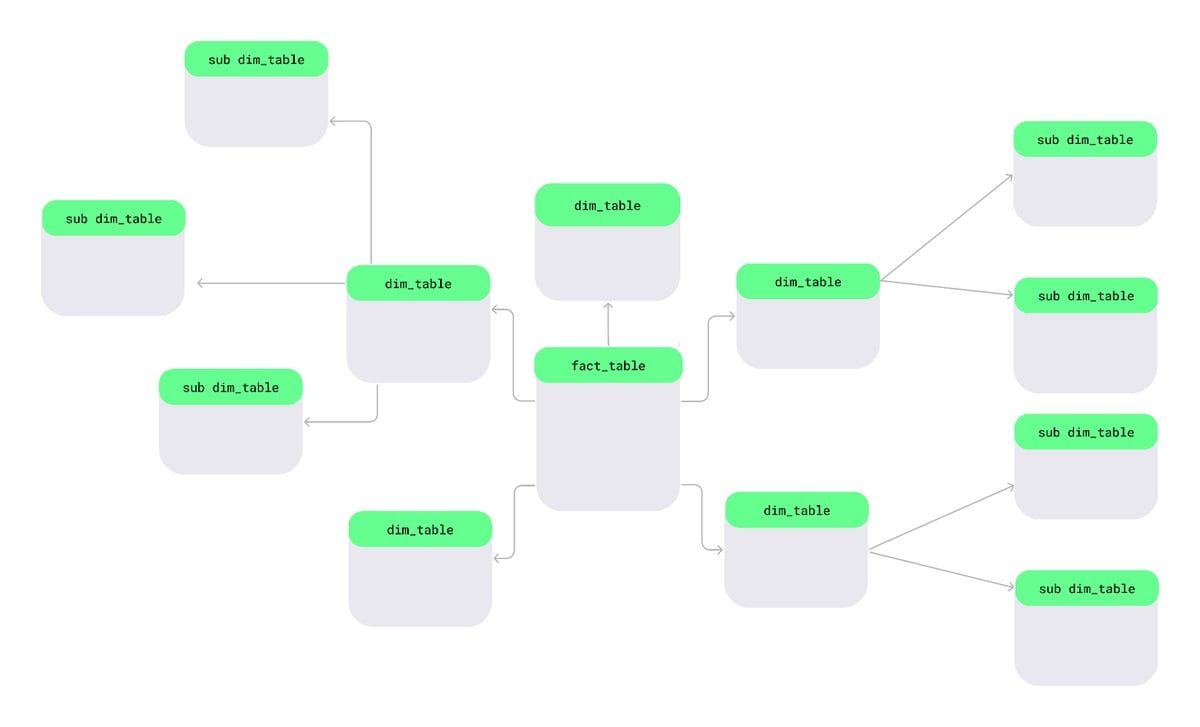
Bố cục snowflake schema. Ảnh: Tác giả.
Hãy xem các đặc điểm chính của snowflake schema khiến nó khác biệt với những schema khác:
- Bảng dimension nhiều cấp: Chúng ta có thể chia nhỏ các bảng dimension thành các bảng cụ thể hơn. Ví dụ, nếu tôi muốn theo dõi vị trí cửa hàng, thay vì đưa tất cả chi tiết vị trí vào một bảng lớn, tôi có thể tách thành các bảng riêng cho quốc gia, bang/tỉnh và thành phố. Như vậy, mỗi bảng chỉ chứa thông tin cần thiết để giảm dư thừa và cải thiện tổ chức.
- Chuẩn hoá để tiết kiệm lưu trữ: Khác với star schema, snowflake schema tuân theo thiết kế chuẩn hoá, giúp tránh trùng lặp dữ liệu. Ví dụ, thay vì lặp lại danh mục sản phẩm như
Electronicscho mọi sản phẩm, tôi có thể lưu danh mục ở một bảng riêng và liên kết với từng sản phẩm. - Phù hợp với dimension có phân cấp hoặc dữ liệu tham chiếu dùng chung: Việc tách bảng có thể thuận tiện cho quản lý, nhưng cần cân bằng với độ phức tạp truy vấn và công cụ BI.
Hãy hiểu qua một sơ đồ snowflake schema đơn giản. Ở trung tâm là bảng fact, chứa dữ liệu đo lường. Nó kết nối tới các bảng dimension mô tả các fact, và các bảng dimension này tiếp tục phân nhánh thành các bảng phân dimension, tạo thành cấu trúc như bông tuyết.
Ví dụ, Product có thể tham chiếu Category và Manufacturer, Customer tham chiếu Location, Store tham chiếu Region. Các giao dịch có số tiền cần được xem xét như sự kiện ở grain riêng, thay vì mặc định là một dimension của Customer.
| Bảng | Các cột minh họa | Vai trò và quan hệ |
|---|---|---|
| Date | Date_ID, Date, Month, Year | Dimension ngày, khóa Date_ID |
| Manufacturer | Manufacturer_ID, Manufacturer_Name | Nhà sản xuất; Product tham chiếu Manufacturer_ID |
| Category | Category_ID, Category_Name | Danh mục; Product tham chiếu Category_ID |
| Product | Product_ID, Product_Name, Category_ID, Manufacturer_ID | Dimension sản phẩm; Category_ID và Manufacturer_ID là khóa ngoại |
| Location | Location_ID, Country, State, City | Địa lý dùng chung; Customer tham chiếu Location_ID |
| Customer | Customer_ID, Customer_Name, Location_ID | Dimension khách hàng |
| Region | Region_ID, Region_Name | Vùng; Store tham chiếu Region_ID |
| Store | Store_ID, Store_Name, Region_ID | Dimension cửa hàng |
| Sales | Sales_ID, Date_ID, Product_ID, Customer_ID, Store_ID, Sales_Amount, Units_Sold | Fact bán hàng với khóa ngoại đến dimension liên quan |
| Transaction | Customer_ID, Transaction_ID, Transaction_Amount, Payment_Method | Sự kiện giao dịch riêng; xác định grain theo Transaction_ID, không dùng như dimension khách hàng |
Bảng dưới đây minh họa các thành phần của mô hình mở rộng và quan hệ cần khai báo. Transaction là bảng sự kiện riêng; Product mang khóa Manufacturer_ID để nối đến nhà sản xuất. SQL kế tiếp chỉ triển khai tập con cần cho truy vấn tổng doanh số theo Category.
Ở một cơ sở dữ liệu thử nghiệm riêng, ví dụ snowflake dưới đây chuẩn hóa Product thành các bảng Category và Manufacturer. Customer và Date được khai báo đầy đủ; Sales tham chiếu đúng tên bảng số ít đã tạo.
-- Chạy riêng với ví dụ star schema
CREATE TABLE Category (
    Category_ID INT PRIMARY KEY,
    Category_Name VARCHAR(50)
);
CREATE TABLE Manufacturer (
    Manufacturer_ID INT PRIMARY KEY,
    Manufacturer_Name VARCHAR(100)
);
CREATE TABLE Product (
    Product_ID INT PRIMARY KEY,
    Product_Name VARCHAR(100),
    Category_ID INT,
    Manufacturer_ID INT,
    FOREIGN KEY (Category_ID) REFERENCES Category(Category_ID),
    FOREIGN KEY (Manufacturer_ID) REFERENCES Manufacturer(Manufacturer_ID)
);

CREATE TABLE Customer (
    Customer_ID INT PRIMARY KEY,
    Customer_Name VARCHAR(100),
    Location VARCHAR(50)
);

CREATE TABLE "Date" (
    Date_ID INT PRIMARY KEY,
    "Date" DATE,
    Year INT,
    Month VARCHAR(20)
);

CREATE TABLE Sales (
    Sales_ID INT PRIMARY KEY,
    Product_ID INT,
    Customer_ID INT,
    Date_ID INT,
    Sales_Amount DECIMAL(10, 2),
    FOREIGN KEY (Product_ID) REFERENCES Product(Product_ID),
    FOREIGN KEY (Customer_ID) REFERENCES Customer(Customer_ID),
    FOREIGN KEY (Date_ID) REFERENCES "Date"(Date_ID)
);
Truy vấn sau tính tổng doanh số theo danh mục sản phẩm bằng đường nối Sales → Product → Category. Chuẩn hóa có thể giảm việc lặp lại thuộc tính danh mục; nó không tự bảo đảm truy vấn nhanh hơn hay tổng dung lượng nhỏ hơn trong mọi hệ thống:
SELECT cat.Category_Name, SUM(s.Sales_Amount) AS TotalSales
FROM Sales s
JOIN Product p ON s.Product_ID = p.Product_ID
JOIN Category cat ON p.Category_ID = cat.Category_ID
GROUP BY cat.Category_Name;
Ưu điểm và hạn chế của snowflake schema
Giống như star schema, snowflake schema cũng có những ưu điểm riêng. Hãy xem đó là gì:
- Ít lặp lại thuộc tính dimension: Ví dụ, tên danh mục chỉ cần quản lý trong bảng Category. Khóa vẫn lặp trong các hàng tham chiếu và tính nhất quán cần được kiểm soát.
- Khả năng tiết kiệm lưu trữ: Tách các thuộc tính dimension lặp lại có thể giảm dung lượng; lợi ích thực tế còn phụ thuộc kích thước bảng, nén cột và chi phí của khóa/bảng bổ sung.
Hạn chế: Chuẩn hóa dimension làm tăng số bảng và đường nối cần quản lý. Điều này có thể ảnh hưởng hiệu năng và trải nghiệm sử dụng BI. Cần đội ngũ hiểu quan hệ, grain và vận hành mô hình; không có quy tắc chỉ đội DBA lớn mới được dùng snowflake.
Sử dụng cách tiếp cận lai (Hybrid)
Trong các dự án thực tế, thường sử dụng cả hai mẫu ở những lớp khác nhau để kết hợp điểm mạnh của mỗi cách tiếp cận:
- Giữ cấu trúc chuẩn hoá hơn (snowflake) ở lớp kho để đảm bảo nhất quán và dễ bảo trì
- Xuất các data mart dạng ngôi sao hoặc view phi chuẩn hoá cho BI và báo cáo
Cách này giúp đội ngũ cân bằng giữa tính toàn vẹn và quản trị dữ liệu với khả năng tiêu thụ phân tích nhanh, đơn giản.
Star Schema vs Snowflake Schema
Cả star và snowflake schema đều được dùng rộng rãi trong kho dữ liệu, nhưng đặc điểm riêng khiến chúng phù hợp với các nhu cầu khác nhau. Hãy xem chúng khác nhau ra sao về cấu trúc, hiệu năng, yêu cầu lưu trữ và trường hợp sử dụng.
Cấu trúc
Trong star schema, tất cả các bảng dimension kết nối trực tiếp với một bảng fact trung tâm. Điều này có nghĩa toàn bộ dữ liệu tham chiếu của bạn chỉ cách dữ liệu chính một bước, giúp dễ hiểu và làm việc.
Ngược lại, snowflake schema chia các bảng dimension thành các bảng phân dimension nhỏ, cụ thể hơn. Ví dụ, bạn có thể có các bảng riêng cho quốc gia, bang/tỉnh và thành phố thay vì một bảng vị trí. Mặc dù tạo ra cấu trúc có tổ chức và chi tiết hơn, nó cũng đòi hỏi nhiều kết nối (join) hơn để truy cập dữ liệu — là lý do chính khiến snowflake schema phức tạp hơn star schema.
Hiệu năng
Star schema thường đơn giản hóa truy vấn vì dimension nối trực tiếp đến fact. Đây là một lý do để cân nhắc nó cho BI; vẫn cần đo thời gian chạy, lượng dữ liệu quét và chi phí trên nền tảng thực tế.
Snowflake bổ sung đường nối qua các bảng dimension đã chuẩn hóa. Chi phí của các phép nối phụ thuộc kế hoạch truy vấn, thống kê, bộ nhớ đệm và hệ lưu trữ; không thể kết luận luôn chậm hơn từ hình dạng schema.
Yêu cầu lưu trữ
Star schema tốn nhiều không gian lưu trữ hơn vì lưu thông tin dư thừa trong các bảng dimension. Ví dụ, nếu nhiều sản phẩm thuộc cùng một danh mục, tên danh mục sẽ lặp lại cho mỗi sản phẩm, làm tăng nhu cầu lưu trữ.
Snowflake giảm việc lặp lại các thuộc tính dimension bằng cách tách bảng, chẳng hạn Category. Điều đó không có nghĩa mọi dữ liệu chỉ xuất hiện đúng một lần, hoặc tổng dung lượng luôn thấp hơn sau khi tính khóa và cấu trúc bổ sung.
Trường hợp sử dụng
Star schema lý tưởng cho hệ thống xử lý phân tích trực tuyến (OLAP), báo cáo và tác vụ business intelligence. Sự đơn giản khiến chúng hoàn hảo cho các tình huống cần tốc độ và dễ sử dụng, như tạo dashboard nhanh hoặc báo cáo doanh số.
Snowflake có thể dùng trong kho phân tích khi dimension có phân cấp rõ và dữ liệu tham chiếu cần quản lý tập trung. Không nên chọn schema chỉ dựa vào ngành tài chính hay nhầm nó với thiết kế cơ sở dữ liệu giao dịch của một CRM.
Bảng so sánh
Dưới đây là so sánh nhanh giữa star và snowflake schema để giúp bạn quyết định cái nào phù hợp nhất với nhu cầu dữ liệu. Tôi đã làm nổi bật các khác biệt chính trong bảng này, tập trung vào cấu trúc, hiệu năng, lưu trữ và trường hợp sử dụng:
|
Tính năng |
Star schema |
Snowflake schema |
Cách tiếp cận lai |
|
Cấu trúc |
Bảng fact trung tâm liên kết tới các dimension phi chuẩn hoá |
Bảng fact trung tâm liên kết tới các dimension chuẩn hoá |
Mô hình lõi chuẩn hoá, cộng thêm các data mart dạng ngôi sao hoặc view phi chuẩn hoá cho lớp tiêu thụ |
|
Độ phức tạp |
Đơn giản, ít phép nối hơn |
Phức tạp, nhiều phép nối hơn |
Trung bình, có nhiều phần chuyển động, nhưng mỗi lớp đơn giản hơn cho mục đích của nó |
|
Dư thừa dữ liệu |
Dư thừa cao do dimension phi chuẩn hoá |
Dư thừa thấp do dimension chuẩn hoá |
Dư thừa ở mức trung bình do phi chuẩn hoá có chọn lọc |
|
Hiệu năng truy vấn |
Có thể đơn giản hóa truy vấn BI; cần đo trên tải thực tế |
Có thêm đường nối; hiệu năng phụ thuộc nền tảng và truy vấn |
Có thể tối ưu lớp BI riêng; vẫn cần kiểm chứng |
|
Lưu trữ |
Có thể tăng dung lượng dimension do thuộc tính lặp |
Có thể giảm thuộc tính lặp, phụ thuộc nén và cấu trúc bảng |
Phụ thuộc số mart, view và cách vật hóa; không có mức cố định |
|
Dễ bảo trì |
Dễ thiết kế và bảo trì |
Khó thiết kế và bảo trì hơn |
Có thể dựng lại mart từ lõi được quản lý, nhưng cần vận hành nhiều lớp |
|
Phù hợp nhất cho |
BI cần dimension dễ dùng và đường nối rõ; áp dụng được cả ở quy mô lớn |
Dimension có phân cấp và dữ liệu tham chiếu cần chuẩn hóa |
Nền tảng dữ liệu hiện đại vừa cần quản trị vừa cần hiệu năng BI |
Chọn Schema phù hợp
Khi nào dùng star schema
Nếu mục tiêu chính của bạn là tổ chức dữ liệu đơn giản và nhanh chóng, star schema sẽ rất phù hợp. Dùng trong các trường hợp sau:
- Nếu bạn đang xây dựng mô hình ngữ nghĩa cho công cụ BI (ví dụ, Power BI) và muốn số lượng bảng và quan hệ ít. Nó hỗ trợ lọc/nhóm trực quan và thường hoạt động tốt cho biểu đồ tương tác.
- Nếu thường tổng hợp doanh số theo khu vực, star schema giúp biểu diễn đường nối trực tiếp từ Sales tới dimension khu vực hoặc khách hàng. Kiểm tra tính đúng của quan hệ trước khi tối ưu tốc độ.
- Khi ưu tiên hiệu năng, hãy thử truy vấn đại diện trên star schema rồi đo so với phương án thay thế. Ít phép nối hơn có thể có lợi, nhưng đây không phải kết quả đo hay kinh nghiệm triển khai do STALI công bố.
- Star schema có thể dùng cho tập dữ liệu nhỏ, trung bình hoặc lớn. Đánh giá kích thước và tốc độ thay đổi của dimension, mức nén và công sức quản lý thay vì đặt ngưỡng quy mô cứng.
Khi nào dùng snowflake schema
Snowflake schema phù hợp hơn để biểu diễn phân cấp và dữ liệu tham chiếu dùng chung, đặc biệt khi nhiều thuộc tính dimension lặp lại trên nhiều hàng. Dùng trong các trường hợp sau:
- Khi các dimension của bạn có phân cấp rõ ràng (ví dụ, Quốc gia → Bang/Vùng → Thành phố) và bạn muốn mô hình hoá các cấp đó tách biệt thành các bảng.
- Nếu bạn muốn kiểm soát chặt chẽ dữ liệu tham chiếu dùng chung (ví dụ, danh sách chuẩn như danh mục, nhà sản xuất hoặc địa lý) để giảm trùng lặp và dễ giữ định nghĩa nhất quán trong toàn kho dữ liệu.
- Khi thuộc tính tham chiếu như tên khu vực thay đổi, việc quản lý tại bảng riêng có thể giảm số vị trí cần cập nhật. Nếu cần giữ lịch sử, phải thiết kế chính sách phiên bản dimension phù hợp; cập nhật một tên không tự bảo đảm tính đúng cho dữ liệu lịch sử.
- Nếu phân tích của bạn liên quan đến nhiều cấp dữ liệu, snowflake schema có thể giúp bạn tổ chức và biểu diễn các mối quan hệ này một cách rõ ràng.
Lựa chọn schema trong kho dữ liệu đám mây
Trong nhiều kho dữ liệu đám mây hiện đại, lưu trữ tương đối rẻ so với tính toán. Điều đó có nghĩa “thêm lưu trữ” từ các dimension phi chuẩn hoá thường kém quan trọng hơn chi phí tính toán để quét và nối dữ liệu.
Khi chọn giữa star và snowflake, hãy cân nhắc mô hình giá của nền tảng (tính toán so với lưu trữ), mức độ đồng thời truy vấn, và liệu bạn có thể dùng cache/view vật hoá để giảm chi phí truy vấn hay không.
Lời kết
Star và snowflake là hai cách tổ chức dimension phục vụ phân tích. Hãy chọn theo grain, quan hệ, nhu cầu sử dụng BI và kết quả đo trên nền tảng thực tế; có thể kết hợp cả hai ở các lớp khác nhau.
Áp dụng và kiểm tra mô hình
Hai ví dụ SQL là các mô hình rút gọn, có thể chạy riêng để kiểm tra khóa và phép tổng hợp. Phần kiểm tra biên tập trên SQLite dùng hai bản ghi bán hàng 100 và 150: truy vấn star cho tổng TP.HCM bằng 250, truy vấn snowflake cho danh mục Văn phòng bằng 250; một bản ghi tham chiếu sản phẩm không tồn tại bị từ chối. Đây là kiểm tra tính đúng của ví dụ, không phải benchmark hiệu năng hoặc xác nhận đã thử trên mọi hệ quản trị.
Khi áp dụng ở hệ quản trị khác, kiểm tra kiểu số tiền, quy tắc định danh và việc hệ thống có thực thi khóa ngoại hay không. Khóa trong ví dụ không thay thế quy trình kiểm định dữ liệu nguồn.
Xem thêm mô hình ngữ nghĩa Power BI và catalog dữ liệu trong doanh nghiệp.
Đối chiếu: hướng dẫn mô hình star schema của Microsoft; mô hình hóa và điều kiện hiệu năng trên Databricks; ràng buộc dữ liệu trong PostgreSQL.
Câu hỏi thường gặp
Mục đích của indexing trong các schema này là gì?
Index có thể tăng tốc một số truy vấn trong hệ cơ sở dữ liệu hỗ trợ kiểu index đó, đồng thời có chi phí lưu trữ và cập nhật. Các nền tảng phân tích cột hoặc lakehouse có cơ chế tối ưu khác; không mặc định mọi truy vấn đều cần thêm index.
Bảng dimension và bảng fact nghĩa là gì?
Các bảng dimension lưu trữ thuộc tính mô tả (như tên sản phẩm hoặc ngày tháng) mô tả dữ liệu trong bảng fact. Trong khi đó, các bảng fact lưu dữ liệu định lượng, như con số doanh số hoặc giá trị giao dịch, và kết nối với các bảng dimension.
Các schema này có phù hợp cho dữ liệu phi cấu trúc không?
Star và snowflake mô hình hóa dữ liệu thành bảng có cấu trúc để phân tích. Dữ liệu bán cấu trúc hoặc phi cấu trúc có thể cần trích xuất thuộc tính, chuẩn bị và ánh xạ trước. NoSQL và data lake là những lựa chọn công nghệ lưu trữ, không tự thay thế bước thiết kế mô hình phân tích.
Tôi có thể thiết kế star và snowflake schema như thế nào?
Để tạo và trực quan hoá các schema này, bạn có thể dùng công cụ mô hình dữ liệu (ERDPlus), công cụ BI (Tableau, Power BI, QlikView) hoặc nền tảng đám mây (Databricks).
Có lựa chọn thay thế nào cho star và snowflake schema không?
Có, bạn có thể dùng Galaxy schema, mô hình Data Vault hoặc các mô hình chiều phức tạp hơn. Các lựa chọn này chủ yếu khác nhau ở cách tổ chức dữ liệu và xử lý mối quan hệ giữa các thông tin.
Ứng dụng thực tế với STALI
Với chủ đề Star schema và snowflake schema, hãy thử trên dữ liệu và tiêu chí thành công của chính bạn, gồm độ chính xác, độ trễ và tổng chi phí. Với dữ liệu tiếng Việt, nên thử thêm cách diễn đạt địa phương, tài liệu dài và yêu cầu định dạng đầu ra. Lưu lại cấu hình và kết quả để so sánh các phương án bằng cùng một phép thử.
Kiểm tra mô hình đang được hỗ trợ và mức phí hiện hành tại bảng giá STALI. Giá nhà cung cấp được phân tích trong bài là dữ kiện tham khảo, không thay thế giá bán và điều kiện sử dụng trên STALI.
Để triển khai, đọc tài liệu tích hợp API STALI, sau đó đăng ký tài khoản STALI để quản lý khóa API và sử dụng các mô hình có trong danh mục.
Đọc thêm các phân tích liên quan trên STALI: