Giả sử lưu lượng truy cập ứng dụng tăng 300% và máy chủ tiến gần giới hạn. Bạn nên thêm máy chủ hay tăng tài nguyên trên các máy hiện có? Đây là tình huống minh họa để xác định điểm nghẽn trước khi chọn cách mở rộng.
Tình huống tiến thoái lưỡng nan này thể hiện thách thức cốt lõi của việc mở rộng trong hạ tầng CNTT hiện đại. Khi nhu cầu vượt quá năng lực hiện tại, bạn có hai hướng cơ bản: mở rộng theo chiều ngang (thêm nhiều máy chủ) hoặc mở rộng theo chiều dọc (nâng cấp phần cứng hiện có). Lựa chọn của bạn sẽ định hình kiến trúc, hiệu năng và chi phí hệ thống trong nhiều năm tới.
Cả hai cách đều giải quyết cùng một vấn đề nhưng dựa trên triết lý hoàn toàn khác nhau. Mở rộng theo chiều ngang phân phối tải lên nhiều máy, trong khi mở rộng theo chiều dọc dồn sức mạnh vào ít hệ thống có năng lực cao hơn.
Bài viết phân tích các đánh đổi kỹ thuật, chi phí và vận hành giữa hai cách mở rộng, cùng các tiêu chí để thử nghiệm trên khối lượng công việc của bạn.
Các khái niệm nền tảng và khác biệt kỹ thuật
Khác biệt kiến trúc giữa hai cách mở rộng ảnh hưởng đến phân phối công việc, dữ liệu, giao tiếp và vận hành. Cần xem cả ứng dụng lẫn các phụ thuộc, thay vì chỉ đếm CPU hoặc máy chủ.
Nguyên tắc kiến trúc
Mở rộng theo chiều ngang (scale out) phân phối khối lượng công việc qua thêm các nút hoặc bản sao dịch vụ. Mỗi nút có thể xử lý một phần tải, nhưng ứng dụng cần hỗ trợ định tuyến công việc, quản lý trạng thái và phối hợp dữ liệu phù hợp.
Mở rộng theo chiều dọc (scale up) tăng CPU, RAM, I/O hoặc tài nguyên khác cho một nút. Có thể nâng cấp thiết bị vật lý hoặc đổi cấu hình máy ảo; yêu cầu tương thích và khả năng gián đoạn tùy nền tảng.
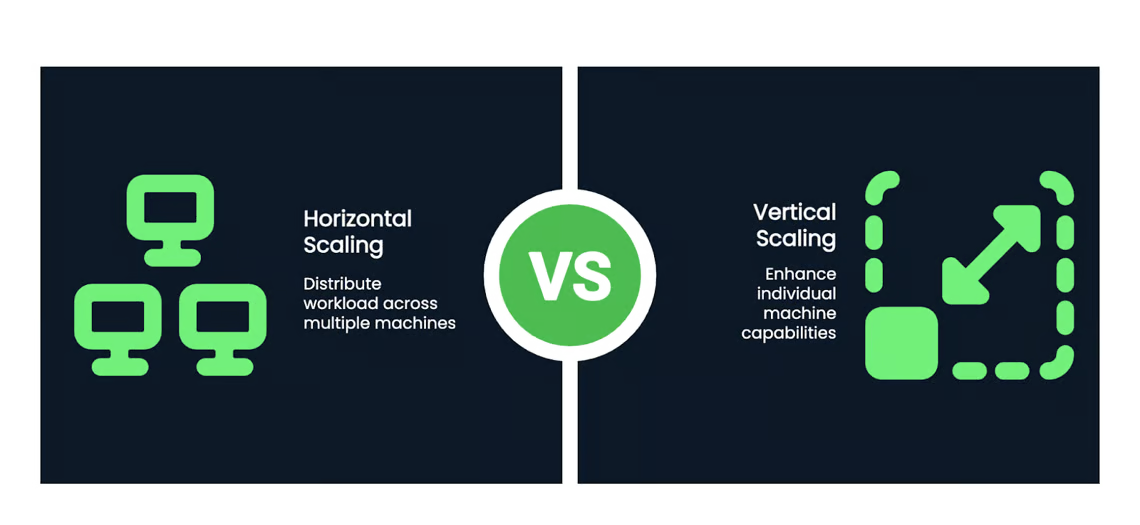
Hình 1 – Sơ đồ khái niệm: thêm các nút khi mở rộng ngang, hoặc tăng tài nguyên của một nút khi mở rộng dọc.
Cơ chế phân bổ tài nguyên
Bộ cân bằng tải có thể định tuyến yêu cầu giữa các máy chủ và kết hợp kiểm tra sức khỏe. Nó không bảo đảm không nút nào quá tải: còn phụ thuộc thuật toán phân phối, loại yêu cầu, trạng thái ứng dụng và năng lực của các dịch vụ phía sau.
Kubernetes hỗ trợ điều phối các bản sao ứng dụng. Việc tự tăng hoặc giảm bản sao cần cấu hình autoscaler, nguồn chỉ số và giới hạn phù hợp; tăng số pod không tự tăng năng lực máy chủ của cụm.
Cassandra và MongoDB có các cơ chế phân vùng hoặc sao chép, tùy kiến trúc và cấu hình. Khả năng tiếp tục phục vụ khi một nút lỗi phụ thuộc số bản sao, quorum, miền lỗi, trạng thái dữ liệu và cơ chế chuyển đổi dự phòng; không tự có chỉ vì thêm nút.
Ví dụ mở rộng dọc có thể là tăng RAM từ 32 GB lên 64 GB, tăng số lõi CPU được cấp từ 16 lên 32, hoặc thay hệ thống lưu trữ bằng NVMe SSD phù hợp. Đây là ví dụ cấu hình, không bảo đảm thông lượng sẽ tăng tương ứng; một số thay đổi yêu cầu dừng hoặc di chuyển máy ảo.
Mở rộng ngang vượt giới hạn tài nguyên của một máy bằng cách thêm nút, nhưng vẫn gặp giới hạn phối hợp, mạng, dữ liệu, quota và chi phí. Mở rộng dọc bị giới hạn bởi cấu hình được nền tảng hỗ trợ và khả năng ứng dụng tận dụng tài nguyên mới.
Đặc tính hiệu năng và đánh đổi
Sự khác nhau về hiệu năng giữa hai cách mở rộng không chỉ là sức mạnh tính toán thuần túy. Mỗi cách tạo ra các mô hình riêng về thông lượng, độ trễ và truy cập dữ liệu, ảnh hưởng trực tiếp đến trải nghiệm người dùng và độ tin cậy hệ thống.
Thông lượng tính toán
Một phép tính minh họa: 10 nút, mỗi nút đo được 1.000 yêu cầu/giây trong cùng điều kiện, có tổng năng lực lý tưởng 10.000 yêu cầu/giây. Thông lượng thực có thể thấp hơn do phân phối tải, phối hợp và phụ thuộc dùng chung. Cần thử tải cả hệ thống, không suy ra mở rộng vô hạn từ phép cộng này.
Tác vụ dễ chia độc lập thường thuận lợi cho mở rộng ngang. Máy chủ web, API hoặc microservice không giữ trạng thái cục bộ có thể phân phối yêu cầu giữa các bản sao; phụ thuộc dùng chung như cơ sở dữ liệu vẫn có thể là nút thắt.
Một nút 64 lõi có thể hữu ích khi chương trình khai thác được nhiều luồng và lợi ích của bộ nhớ dùng chung lớn hơn chi phí phối hợp qua mạng. Hiệu quả so với nhiều máy nhỏ phụ thuộc chương trình và phần cứng; cần đo thay vì mặc định máy lớn luôn tốt hơn.
Với chương trình đơn luồng nặng CPU, thêm nhiều lõi thường không tăng tốc chính luồng đó; hiệu năng mỗi lõi, bộ nhớ, I/O hoặc thay đổi thuật toán có thể quan trọng hơn. Cơ sở dữ liệu, huấn luyện ML và phân tích thời gian thực đều có thể dùng một nút hoặc cụm, tùy cách chia công việc và nhu cầu dữ liệu.
Hồ sơ độ trễ
Đặc tính độ trễ khác nhau rõ rệt giữa các cách mở rộng, đặc biệt với dịch vụ có trạng thái, duy trì phiên người dùng hoặc bộ nhớ đệm.
Phân phối công việc có thể thêm giao tiếp mạng và đồng bộ, đồng thời giảm một số tranh chấp trên từng nút. Tác động đến độ trễ phụ thuộc đường gọi, cache, vị trí dữ liệu và lượng phối hợp cần thiết.
Khi có phân hoạch mạng, hệ thống phân tán không thể đồng thời đáp ứng đầy đủ các bảo đảm nhất quán và sẵn sàng theo định nghĩa của CAP. Đây không phải công thức chung để tính độ trễ hoặc yêu cầu mọi hệ thống phải chọn nhất quán cuối cùng; các giao thức và yêu cầu giao dịch cụ thể vẫn cần được đánh giá.
Xử lý trên cùng nút có thể giảm một số vòng giao tiếp mạng, nhưng nâng cấu hình không tự chuyển mọi thành phần lên một máy hay bảo đảm độ trễ thấp hơn. Tranh chấp CPU, bộ nhớ, I/O, khóa và hàng đợi đều có thể gây đuôi độ trễ dài khi tải tăng.
Chiến lược tối ưu hóa cơ sở dữ liệu
Bảng sau tóm tắt năm khía cạnh và các điều kiện cần kiểm tra khi mở rộng cơ sở dữ liệu.
| Khía cạnh | Mở rộng ngang | Mở rộng dọc |
|---|---|---|
| Phân phối truy vấn | Có thể phân phối qua nhiều nút hoặc shard, tùy kiến trúc; cần định tuyến và quản lý dữ liệu. | Có thể tập trung nhiều công việc trên nút có tài nguyên lớn hơn; không loại bỏ phụ thuộc ngoài nút. |
| Hiệu năng đọc | Read replica có thể chia tải đọc phù hợp; vẫn có độ trễ sao chép và giới hạn nguồn/phụ thuộc. | Phụ thuộc CPU, cache, bộ nhớ, I/O và kế hoạch truy vấn; không chỉ giới hạn I/O. |
| Hiệu năng ghi | Phụ thuộc phân vùng, giao dịch, giao thức nhất quán và tranh chấp; thêm node không tự tăng ghi tuyến tính. | Tăng tài nguyên có thể giúp nếu nút đó là giới hạn; khóa, log hoặc thiết kế truy vấn vẫn có thể chi phối. |
| Truy vấn phức tạp | Join/giao dịch xuyên shard có thể thêm phối hợp; mức hỗ trợ và tối ưu tùy hệ quản trị. | Có thể tránh một phần giao tiếp xuyên nút, nhưng tốc độ vẫn phụ thuộc dữ liệu, chỉ mục và phần mềm. |
| Trần mở rộng | Hữu hạn bởi phần mềm, quota, mạng, phối hợp, dữ liệu và chi phí; không có số nút gần như vô hạn. | Hữu hạn bởi cấu hình nền tảng hỗ trợ và khả năng phần mềm tận dụng tài nguyên. |
Bảng 1 – Các đánh đổi khi mở rộng cơ sở dữ liệu; thông lượng và độ trễ cần được kiểm thử trên truy vấn thực tế.
Mở rộng cơ sở dữ liệu theo chiều ngang có thể dùng sharding hoặc bản sao đọc cho những mục tiêu khác nhau. Truy vấn xuyên shard và tái phân phối dữ liệu có thể thêm chi phí; replica chỉ đọc không tự mở rộng khả năng ghi. Khả năng mở rộng đọc còn bị giới hạn bởi nguồn dữ liệu, độ trễ sao chép và thành phần dùng chung.
Tăng tài nguyên cho một nút cơ sở dữ liệu có thể giữ cách triển khai và nhiều truy vấn đơn giản hơn, nhưng không bảo đảm join hay giao dịch luôn nhanh hơn. Kế hoạch truy vấn, chỉ mục, tập dữ liệu, khóa và giới hạn I/O vẫn quyết định kết quả; cấu hình tối đa của nền tảng là một giới hạn cần tính.
Cả hai cách đều có thể gặp hiệu quả giảm dần. Với scale out, chi phí phối hợp và thành phần tuần tự có thể tăng; với scale up, giới hạn phần mềm, băng thông bộ nhớ hoặc I/O có thể khiến tài nguyên mới không được tận dụng hết.
Mẫu triển khai trên các ngành
Quyết định mở rộng trong thế giới thực phụ thuộc nhiều vào nhu cầu theo ngành và mô hình hành vi người dùng. Hãy xem xét cách các lĩnh vực khác nhau áp dụng mở rộng ngang và dọc để giải quyết thách thức riêng.
Nền tảng thương mại điện tử
Trong một ví dụ thương mại điện tử, các sự kiện mua sắm lớn có thể làm tải tăng mạnh. Tầng web, thanh toán, tồn kho và gợi ý có mẫu tải khác nhau, nên có thể cần các chính sách mở rộng riêng. Không suy ra số phiên bản hoặc kiến trúc thực tế của một doanh nghiệp chỉ từ tên sự kiện.
Một thiết kế minh họa kết hợp hai cách: tăng bản sao tầng ứng dụng để xử lý yêu cầu trang, đồng thời tăng tài nguyên nút cơ sở dữ liệu khi nút đó là giới hạn. Nếu ghi hoặc dữ liệu tiếp tục tăng, cần đánh giá thêm replication, partitioning hoặc sharding phù hợp.
Với sự kiện đã biết trước, có thể dùng dữ liệu lịch sử để lập lịch cấp phát và làm nóng tài nguyên sớm. Vẫn cần kiểm thử tải, dự phòng và kế hoạch ứng phó khi dự báo sai; cấp phát trước không bảo đảm tránh mọi gián đoạn hay một mức thiệt hại doanh thu cụ thể.
Kiến trúc phát trực tuyến
Dịch vụ phát trực tuyến thường gồm nhiều chức năng như xác thực, gợi ý, xử lý video và phân phối nội dung. Chúng có thể được chia thành các dịch vụ hoặc công việc có khả năng mở rộng riêng. Số lượng dịch vụ không tự chứng minh khả năng mở rộng; cần xem tải và các phụ thuộc giữa chúng.
Trong một thiết kế như vậy, nhu cầu xem có thể làm tăng tải xác thực hoặc gợi ý, trong khi tải xử lý nội dung mới ảnh hưởng đến pipeline mã hóa. Mở rộng từng thành phần chỉ hiệu quả nếu các phụ thuộc và giới hạn toàn hệ thống được theo dõi.
Một pipeline video có thể tăng số worker để xử lý nhiều công việc song song và dùng CPU, GPU hoặc bộ tăng tốc phù hợp trong từng worker. Chọn phần cứng mạnh hơn là một cách tăng năng lực nút; đồng thời vẫn có thể mở rộng ngang. Việc dùng phần cứng chuyên dụng không đồng nghĩa hệ thống chỉ có thể mở rộng dọc.
Phân phối theo địa lý và cache tại biên có thể giảm đường truyền tới người xem. Khả năng phục vụ còn phụ thuộc cache hit, đồng bộ nội dung, năng lực origin và chính sách triển khai; thêm điểm biên không tự bảo đảm độ trễ tối thiểu.
IoT và điện toán biên
IoT có thể có thiết bị bị giới hạn tài nguyên và nguồn dữ liệu phân bố rộng. Khi chọn nơi xử lý, cần cân nhắc độ trễ, kết nối, năng lực thiết bị và dữ liệu phải truyền tới đám mây.
Một thiết bị biên xử lý cảm biến có thể cần thêm năng lực CPU, GPU hoặc bộ tăng tốc để đáp ứng yêu cầu độ trễ. Chọn phần cứng cho một thiết bị và tăng tài nguyên của thiết bị đó theo thời gian là các quyết định khác nhau; yêu cầu an toàn và kiến trúc thực tế cần được đánh giá riêng.
Dịch vụ IoT được quản lý có thể tiếp nhận thông điệp từ nhiều thiết bị và mở rộng một phần hạ tầng phía nhà cung cấp. Với AWS IoT Core, vẫn phải kiểm tra quota, tốc độ gửi, kích thước thông điệp, hạn mức kết nối và hành vi khi bị giới hạn; không bảo đảm mọi đợt tăng tải đều không ảnh hưởng kết nối.
Trong kiến trúc IoT minh họa, gateway có thể tăng tài nguyên xử lý cục bộ, còn backend tăng số worker để phân tích dữ liệu tổng hợp. Cả tầng biên và backend đều có thể kết hợp hai cách tùy giới hạn cụ thể.
Cách tổ chức theo tầng giúp đặt xử lý ở vị trí thích hợp. Lọc hoặc tổng hợp tại biên có thể giảm dữ liệu truyền lên, nhưng lợi ích băng thông, năng lượng và độ trễ cần được đo trong điều kiện kết nối và dự phòng thực tế.
Động lực chi phí và mô hình tối ưu
Cân nhắc chi phí thường chi phối quyết định mở rộng hơn cả yếu tố kỹ thuật, đặc biệt khi tổ chức cân bằng yêu cầu hiệu năng với hạn chế ngân sách. Hệ quả tài chính của mỗi cách mở rộng tạo ra mô hình chi tiêu và cam kết dài hạn rất khác nhau.
Phân tích chi tiêu vốn (CapEx)
Mở rộng dọc bằng cách mua thiết bị mạnh có thể cần khoản đầu tư tập trung. Một cấu hình 128 lõi CPU, 1 TB RAM và NVMe chỉ là ví dụ yêu cầu phần cứng; giá phụ thuộc thiết bị, hỗ trợ, giấy phép và thời điểm mua. Cần có báo giá với điều kiện hỗ trợ và giấy phép tương ứng trước khi lập dự toán.
Về số học, mười máy giả định giá 5.000 USD mỗi máy có cùng giá mua tổng 50.000 USD với một máy giả định giá 50.000 USD. Đây chỉ là ví dụ chia ngân sách, không phải báo giá, so sánh năng lực tương đương hay kết luận TCO; còn phải tính mạng, phần mềm, vận hành và dự phòng.
Trên public cloud, cả cấu hình nút lớn lẫn nhiều nút đều có thể được thuê theo mức sử dụng hoặc các hình thức cam kết tùy dịch vụ. Không tự mua phần cứng không đồng nghĩa không có phí khởi đầu, mức dùng tối thiểu hoặc chi phí triển khai.
Mua thêm các máy nhỏ theo từng giai đoạn có thể giúp chia thời điểm đầu tư, nếu kiến trúc cho phép mở rộng theo cách đó. Tuy nhiên, cam kết thuê bao, hỗ trợ, giấy phép và năng lực dự phòng có thể hạn chế mức linh hoạt; không có ưu thế tài chính chung cho mọi hoàn cảnh kinh tế.
Phân tích tổng chi phí sở hữu (TCO)
Ít máy hơn có thể giảm một phần công việc quản lý, nhưng TCO còn gồm giấy phép, hỗ trợ, điện, kết nối và dự phòng. Nếu chỉ có một nút phục vụ quan trọng thì nút đó có thể thành điểm lỗi đơn; mở rộng dọc vẫn có thể kết hợp nhiều bản sao và cơ chế HA.
Mở rộng ngang có thể tăng số thành phần cần theo dõi: định tuyến, mạng, triển khai, dữ liệu và failover. Một số dịch vụ được quản lý giảm công việc này, nhưng không loại bỏ yêu cầu kiểm tra cấu hình, mức phí và năng lực vận hành.
Không thể kết luận một máy lớn luôn tiết kiệm điện hoặc làm mát hơn nhiều máy nhỏ có năng lực tương đương. Cần đo công suất theo mức tải, hiệu suất sử dụng, loại bộ xử lý, thiết bị phụ trợ và phương án dự phòng trong cùng khối lượng công việc.
Giấy phép có thể tính theo lõi, socket, máy, người dùng hoặc quy tắc khác. Một máy 32 lõi và tám máy 4 lõi đều có tổng 32 lõi, nhưng giá có thể khác do mức tối thiểu, hệ số lõi, quyền ảo hóa hoặc điều khoản HA. Phải dùng điều kiện cấp phép thực tế, không mặc định một máy luôn rẻ hơn.
Kinh tế của tự động mở rộng
Autoscaling có thể điều chỉnh số tài nguyên theo chỉ số hoặc lịch đã cấu hình. Với lưu lượng có đỉnh hằng ngày, tăng năng lực trước đỉnh và giảm sau đó có thể hạn chế thời gian nhàn rỗi, nếu thời gian khởi động và phần tải nền cho phép.
Mức tiết kiệm phụ thuộc tải, cấu hình, phí dịch vụ và phương án so sánh. Không có tỷ lệ tiết kiệm chung cho mọi ứng dụng; hãy so hóa đơn hoặc mô hình chi phí trong cùng điều kiện. Tải ổn định có thể ít được lợi từ thu hẹp tài nguyên nhưng vẫn cần đánh giá dự phòng và vận hành.
Có thể tự động hóa điều chỉnh cấu hình nút trong những nền tảng hỗ trợ, nhưng thay đổi loại máy không phải lúc nào cũng thực hiện được khi máy đang chạy. Ví dụ, một số thay đổi loại EC2 EBS-backed yêu cầu stop/start; cần tính thời gian gián đoạn, tương thích và phương án thay thế nút.
Chi phí autoscaling có thể gồm giám sát/chỉ số, điều phối, thời gian tài nguyên chồng lấn, làm nóng, dung lượng nền và truyền dữ liệu. Mức phí khác nhau theo dịch vụ; hãy đo cả chi phí lẫn độ trễ, lỗi và số lần điều chỉnh thay vì mặc định chi phí ẩn luôn nhỏ.
Kiến trúc lai và xu hướng mới nổi
Hạ tầng hiện đại ngày càng kết hợp cả hai cách mở rộng thay vì chọn duy nhất một. Những chiến lược lai và công nghệ mới này đang định hình lại cách các tổ chức nghĩ về hoạch định năng lực và phân bổ tài nguyên.
Mở rộng qua Kubernetes
Kubernetes hỗ trợ điều phối tài nguyên và các cơ chế autoscaling khác nhau. Cần phân biệt số bản sao pod, tài nguyên từng pod và năng lực các node; mỗi lớp cần cấu hình và chỉ số riêng.
HPA điều chỉnh số bản sao theo các chỉ số được cấu hình, cần nguồn metrics tương ứng. VPA là thành phần cài đặt riêng để khuyến nghị hoặc điều chỉnh requests và, theo cấu hình, limits CPU/bộ nhớ của pod. Phương thức cập nhật có thể tạo lại pod hoặc thay đổi tại chỗ nếu phiên bản và cấu hình hỗ trợ.
HPA và VPA có thể phục vụ các mục tiêu bổ sung, nhưng không bảo đảm luôn tạo một cấu hình tối ưu. Pod mới còn cần node đủ tài nguyên, tải ứng dụng sẵn sàng và các phụ thuộc chịu được mức tải mới; tăng pod không xử lý mọi nút thắt.
Khi dùng cả hai, cần kiểm tra nguồn chỉ số và khả năng phản hồi qua lại: VPA thay đổi requests có thể làm thay đổi chỉ số sử dụng mà HPA quan sát. Có thể bắt đầu bằng chế độ khuyến nghị của VPA và thử nghiệm có kiểm soát; không khẳng định đây là cách mọi hoặc phần lớn tổ chức triển khai.
HPA có thể dùng nhiều chỉ số và custom/external metrics khi được cung cấp qua API phù hợp. Tự dự đoán nhu cầu hoặc mở rộng theo lịch cần các cơ chế, bộ điều khiển hay dịch vụ bổ sung phù hợp; không phải khả năng được tự kích hoạt trong mọi cụm Kubernetes.
Mở rộng dự đoán dẫn dắt bởi AI
Autoscaling phản ứng điều chỉnh sau khi chỉ số vượt điều kiện đã đặt, không nhất thiết đợi sự cố hiệu năng. Mở rộng dự đoán dùng dữ liệu quá khứ hoặc thông tin sự kiện để chuẩn bị tài nguyên sớm; hiệu quả phụ thuộc dữ liệu, mô hình và thời gian cấp phát.
Mô hình dự đoán có thể xét thời điểm, ngày trong tuần, sự kiện hoặc các yếu tố khác nếu chúng có giá trị trong dữ liệu. Cần kiểm tra dự báo ngoài mẫu, sai số và sự thay đổi hành vi; không thể mặc định mô hình sẽ dự đoán chính xác hoặc giảm chi phí cho mọi ứng dụng.
Những tình huống có sự kiện biết trước như bán hàng, ra mắt nội dung hoặc game có thể phù hợp để lập lịch hay dự đoán mở rộng. Dự báo từ lịch sử có thể kém tin cậy với sự kiện mới; cần kết hợp giới hạn chi phí, năng lực dự phòng và autoscaling phản ứng phù hợp.
Dự báo dư có thể làm tài nguyên nhàn rỗi; dự báo thiếu có thể làm tăng độ trễ hoặc lỗi khi tải tới. Cần chọn mức dự phòng theo yêu cầu dịch vụ, chi phí và sai số quan sát được, đồng thời kiểm tra cơ chế thu hẹp an toàn.
Hội tụ serverless và biên
Một số dịch vụ serverless quản lý việc cấp phát môi trường thực thi và tăng số thực thi đồng thời theo tải. Chúng vẫn có quota, tốc độ mở rộng, giới hạn tài nguyên và cơ chế tính phí riêng; không phải mọi dịch vụ đều scale về 0 hay lên hàng nghìn thực thi ngay lập tức.
Một số nền tảng cho phép chạy hàm tại biên gần người dùng. Khả năng này phụ thuộc nền tảng, vùng hỗ trợ, dịch vụ được phép dùng và giới hạn runtime; lợi ích độ trễ và chi phí phải đánh giá cho đường đi dữ liệu cụ thể.
Để phục vụ nhiều khu vực, cần triển khai và định tuyến phù hợp, đồng bộ dữ liệu và đáp ứng yêu cầu dữ liệu tại từng nơi. Việc ứng dụng dùng serverless không tự làm nó phân phối toàn cầu hoặc mở rộng độc lập ở mọi vùng.
Cần xem các đánh đổi như cold start, thời gian thực thi, trạng thái, tích hợp mạng và phụ thuộc nhà cung cấp. Provisioned concurrency hoặc các chế độ thực thi khác có thể giúp trong một số trường hợp nhưng có phí, phạm vi hỗ trợ và giới hạn riêng; không mặc định các hạn chế đều giảm dần theo thời gian.
Kiến trúc kết hợp có thể đặt tác vụ nhạy độ trễ tại biên và xử lý nặng hơn tại vùng đám mây. Tầng xử lý trung tâm vẫn có thể dùng một nút lớn hoặc nhiều worker; cần chọn theo khả năng chia công việc, dữ liệu và yêu cầu vận hành.
Hướng dẫn triển khai chiến lược
Chọn chiến lược mở rộng phù hợp đòi hỏi đánh giá có hệ thống về đặc điểm ứng dụng, ràng buộc và dự báo tăng trưởng. Khung dưới đây giúp bạn ra quyết định sáng suốt và lập kế hoạch chuyển đổi giữa các cách mở rộng thành công.
Khung quyết định
Đánh giá trạng thái phiên, cache cục bộ và mức gắn kết trước. Không trạng thái cục bộ thường giúp phân phối yêu cầu dễ hơn, còn ứng dụng có trạng thái có thể cần external store, phân vùng hoặc đồng bộ. Có trạng thái không đồng nghĩa bắt buộc chỉ mở rộng dọc.
Phân tích mức tải nền, đỉnh, tốc độ tăng và khả năng dự báo. Cả tải ổn định lẫn biến thiên đều có thể dùng một nút lớn hoặc nhiều nút; lựa chọn còn phụ thuộc thời gian cấp phát, khả năng chia tải, giới hạn dữ liệu và chi phí.
Đánh giá kỹ năng tinh chỉnh hiệu năng, quản lý dữ liệu, giám sát và ứng phó sự cố của đội. Mở rộng ngang thường tăng yêu cầu phối hợp nhiều nút, nhưng không bắt buộc phải dùng microservice hay container. Chọn phạm vi thay đổi phù hợp và bổ sung năng lực vận hành còn thiếu.
Cấu trúc ngân sách ảnh hưởng đến tiến độ đầu tư hoặc cam kết dịch vụ. Cả scale up và scale out đều có thể dùng phần cứng mua/thuê hoặc public cloud; so sánh cùng thời hạn, cấu hình dự phòng, điều kiện giá và phạm vi vận hành trước khi kết luận.
Thiết kế chịu lỗi riêng với quyết định kích cỡ nút. Một nút duy nhất có thể là điểm lỗi đơn; nhiều nút chỉ tạo dự phòng hữu ích khi dữ liệu, định tuyến, failover và miền lỗi được thiết kế đúng. Nhiều nút lớn cũng có thể kết hợp mở rộng dọc với HA.
Xác định các giao dịch, mức cô lập và bảo đảm nhất quán cần có. Cơ sở dữ liệu phân tán có thể hỗ trợ ACID và nhất quán mạnh; mở rộng ngang không bắt buộc nhất quán cuối cùng. Chi phí giao dịch xuyên nút, phân vùng dữ liệu và khả năng phần mềm vẫn cần được đo.
| Cặp tiêu chí nguồn | Cân nhắc với mở rộng dọc | Cân nhắc với mở rộng ngang |
|---|---|---|
| Trạng thái phiên nặng / yêu cầu không trạng thái | Trạng thái cục bộ có thể đơn giản hơn với ít nút nhưng vẫn cần phục hồi và dự phòng. | Không trạng thái cục bộ thường thuận lợi để chia yêu cầu; ứng dụng có trạng thái cũng có thể scale out khi thiết kế lưu trữ/phối hợp phù hợp. |
| Tăng trưởng ổn định / lưu lượng biến thiên | Có thể lên kế hoạch tăng tài nguyên; phải kiểm tra thời gian thay đổi và giới hạn cấu hình. | Có thể thêm/bớt bản sao theo tải; vẫn cần chỉ số, quota, thời gian làm nóng và năng lực dự phòng. |
| Tinh chỉnh hiệu năng / kỹ năng hệ phân tán | Cần biết giới hạn CPU, bộ nhớ, I/O, khóa và truy vấn. | Cần quản lý định tuyến, dữ liệu, phối hợp và failover; không bắt buộc microservice hay container. |
| Vốn ban đầu / ngân sách linh hoạt | Có thể mua hoặc thuê một nút lớn, bằng mô hình tự vận hành hoặc cloud. | Có thể đầu tư từng nhóm nút hoặc thuê dịch vụ; TCO và cam kết hợp đồng vẫn cần so sánh. |
| Điểm lỗi đơn / dự phòng | Một nút duy nhất có thể là điểm lỗi đơn; nhiều nút lớn có thể kết hợp HA. | Nhiều nút không tự có dự phòng đúng: cần replication, failover, đủ năng lực và các miền lỗi phù hợp. |
| ACID nghiêm ngặt / nhất quán cuối cùng | Một số hệ quản trị một nút đơn giản hóa giao dịch, nhưng ACID không bị giới hạn ở một máy. | Hệ phân tán có thể hỗ trợ ACID/nhất quán mạnh hoặc các mô hình khác; chọn theo yêu cầu và khả năng phần mềm, không mặc định eventual consistency. |
Bảng 2 – Sáu nhóm tiêu chí ra quyết định; đây là những yếu tố cần cân nhắc, không phải quy tắc phân loại tuyệt đối.
Lộ trình di trú từ dọc sang ngang
Nếu chọn tách ứng dụng nguyên khối thành dịch vụ, cần xác định các ngữ cảnh giới hạn (bounded contexts), ranh giới dữ liệu và hợp đồng giữa các phần. Đây là một lựa chọn kiến trúc, không phải bước bắt buộc chỉ để chạy nhiều bản sao ứng dụng.
Mẫu strangler fig có thể đưa dần một số chức năng qua dịch vụ mới trong khi hệ thống cũ tiếp tục hoạt động. Vẫn phải quản lý định tuyến, tương thích dữ liệu, xác thực, quan sát và rollback; cách làm từng bước giảm phạm vi thay đổi nhưng không loại hết rủi ro.
Các phần ít giữ trạng thái cục bộ có thể là điểm khởi đầu thuận lợi, nếu ranh giới và phụ thuộc rõ. Không mặc định xác thực là thành phần đơn giản hay không trạng thái: token, phiên, khóa, quyền và thu hồi truy cập vẫn cần thiết kế nhất quán.
Nếu tách kho dữ liệu theo dịch vụ, cần xác định quyền sở hữu dữ liệu, giao dịch liên phần và kế hoạch di chuyển. Đây có thể là phần phức tạp, nhưng không phải dự án scale out nào cũng phải chia cơ sở dữ liệu hay di trú công nghệ.
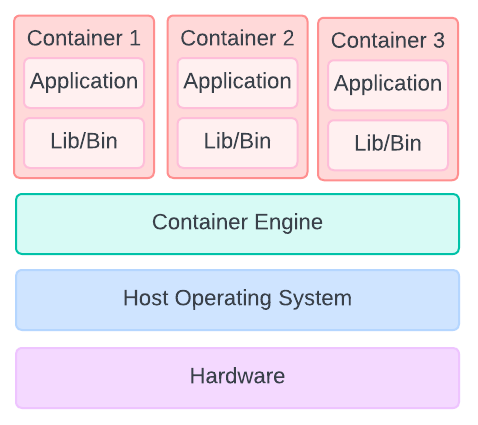
Có thể triển khai thêm bản sao của ứng dụng hiện có, bằng container hoặc các phương thức khác. Container hóa giúp đóng gói và triển khai nhất quán nhưng không tự giải quyết trạng thái, lưu trữ, khóa hoặc các phụ thuộc khiến ứng dụng chưa chạy an toàn trên nhiều bản sao.
Khi chạy nhiều bản sao phía sau cân bằng tải, kiểm tra quản lý phiên, dữ liệu, tác vụ nền, tính idempotent và khả năng retry. Tăng từng bước và quan sát thông lượng, độ trễ, lỗi cùng các phụ thuộc trước khi tăng thêm.
Có thể tăng bản sao tầng web và giữ nút cơ sở dữ liệu lớn hơn trong giai đoạn đầu, hoặc kết hợp tải nền với tài nguyên bổ sung cho giờ cao điểm. Mỗi phương án vẫn cần kiểm thử và kế hoạch phục hồi; lợi ích không được bảo đảm chỉ bằng cách gọi là kiến trúc lai.
Lập kế hoạch di trú dữ liệu cẩn thận khi chuyển từ mở rộng dọc sang ngang. Hệ phân tán thường cần mẫu truy cập dữ liệu, chiến lược bộ đệm và mô hình nhất quán khác. Hãy kiểm thử kỹ các thay đổi này trong môi trường staging trước khi đưa vào sản xuất.
Định hướng tương lai và biên giới nghiên cứu
Công nghệ mới và các mối quan tâm môi trường đang định hình lại các giả định cơ bản về chiến lược mở rộng. Những diễn biến này hứa hẹn sẽ thay đổi cách chúng ta nghĩ về năng lực tính toán, phân bổ tài nguyên và tối ưu hạ tầng.
Hệ quả của điện toán lượng tử
Mở rộng hệ lượng tử là bài toán nghiên cứu khác với cấp phát tài nguyên web thông thường: chất lượng qubit, lỗi, kết nối và khả năng điều khiển đều quan trọng. Tăng số qubit hay độ rối không tự chuyển thành tăng tốc chung cho mọi bài toán.
Hệ lượng tử phải duy trì trạng thái và kiểm soát sai số trong khi tăng quy mô. Hệ cổ điển cũng không tăng tuyến tính chỉ vì thêm lõi nếu chương trình còn phần tuần tự hoặc nút thắt bộ nhớ/I/O. Vì vậy không nên so sánh hai mô hình bằng số bộ xử lý hoặc số qubit đơn thuần.
Trong mô hình lượng tử–cổ điển, hệ cổ điển có thể chuẩn bị công việc, điều khiển và xử lý kết quả của bộ xử lý lượng tử. Đây là bối cảnh nghiên cứu hoặc ứng dụng chuyên biệt, không phải cam kết rằng doanh nghiệp có thể thay scale up/scale out hiện có bằng một bộ xử lý lượng tử.
Cần phân biệt tiềm năng thuật toán lượng tử, minh chứng chuyên biệt và lợi ích đầu cuối đã được kiểm chứng trên bài toán thực. Không mặc định lợi thế thực tế đã tồn tại rộng rãi trong mật mã, tối ưu hóa hay mô phỏng phân tử. Các quyết định mở rộng ứng dụng thông thường vẫn cần dựa trên phần cứng và phần mềm đã đo được.
Rối lượng tử tạo các tương quan đặc biệt nhưng không cho phép truyền thông tin hoặc điều phối tức thời nhanh hơn ánh sáng. Không thể dùng nó để loại bỏ độ trễ mạng giữa các nút xa nhau trong một hệ thống mở rộng ngang.
Mô hình mở rộng bền vững
Lập lịch nhận thức carbon có thể xét cường độ phát thải của lưới điện theo thời gian và vị trí, trong các giới hạn mà khối lượng công việc cho phép. Việc trì hoãn hoặc chuyển nơi chạy phải tôn trọng thời hạn, yêu cầu dữ liệu, chi phí truyền và yêu cầu dịch vụ.
Google mô tả hệ thống lập lịch carbon-intelligent cho các công việc linh hoạt, có thể trì hoãn hoặc chọn vị trí phù hợp. Điều đó không có nghĩa mọi VM hay ứng dụng khách hàng tự được di chuyển hoặc mọi triển khai đều đạt cùng một mức giảm phát thải. Cần xác định đường cơ sở và phương pháp đo cho từng triển khai.
Hiệu quả bền vững cần xét công việc hoàn thành trên mỗi đơn vị năng lượng hoặc phát thải, cùng hiệu suất sử dụng và dự phòng. Không có quy luật scale up luôn tốt hơn scale out về năng lượng; phụ thuộc thiết bị, phần mềm, tải và nguồn điện.
Làm mát bằng chất lỏng và quản lý điện có thể hỗ trợ vận hành phần cứng mật độ cao trong điều kiện phù hợp. Muốn kết luận tiết kiệm năng lượng hoặc carbon phải đo tổng hệ thống, hiệu quả làm mát và vòng đời thiết bị; không suy ra chỉ từ số máy giảm.
Xử lý tại biên có thể giảm lượng dữ liệu truyền nếu lọc hoặc tổng hợp hiệu quả. Đổi lại, cần tính năng lượng thiết bị biên, mức sử dụng, bản sao và vận hành; đặt gần người dùng không tự chứng minh tổng phát thải thấp hơn.
Điều phối phần cứng dị thể
Chiến lược mở rộng hiện đại ngày càng kết hợp các loại bộ xử lý khác nhau trong cùng hạ tầng để tối ưu hiệu năng cho khối lượng công việc cụ thể. CPU, GPU, FPGA và bộ tăng tốc AI chuyên dụng đều xuất sắc ở các tác vụ khác nhau, mở ra cơ hội phân bổ tài nguyên tinh vi.
Kubernetes có thể lập lịch trên các node có cấu hình khác nhau. Cần khai báo tài nguyên và các ràng buộc như nhãn, affinity hoặc bộ mở rộng thiết bị phù hợp; bộ lập lịch chọn trong các node đáp ứng điều kiện, không tự biết phần cứng tối ưu cho mọi ứng dụng.
Ứng dụng có thể chọn worker GPU cho tác vụ phù hợp, node nhiều bộ nhớ cho dữ liệu lớn, hoặc bộ tăng tốc được hỗ trợ cho công việc chuyên biệt. Chọn loại phần cứng, tăng tài nguyên từng nút và tăng số nút là ba quyết định liên quan nhưng không đồng nhất.
Một nền tảng có thể bổ sung các chính sách hoặc bộ lập lịch để xét năng lực, chi phí hay năng lượng. Khả năng cụ thể phải được cấu hình và xác minh; không mặc định Kubernetes tiêu chuẩn tối ưu đồng thời mọi mục tiêu này.
Các công cụ phân tích hoặc ML có thể hỗ trợ khuyến nghị tài nguyên. Cần kiểm tra dữ liệu đầu vào, sai số, giới hạn an toàn và hiệu quả thực tế trước khi tự động áp dụng; dự báo không thay thế hoàn toàn đánh giá kỹ thuật.
Một ứng dụng có thể dùng nhiều loại phần cứng và kết hợp tăng số worker với tăng tài nguyên từng worker. Tính tương thích, định tuyến công việc, dữ liệu và giám sát cần được giữ nhất quán khi kết hợp các lựa chọn này.
Tổng kết mở rộng theo chiều ngang so với chiều dọc
Lựa chọn giữa mở rộng ngang và dọc không phải nhị phân. Đó là sự đồng bộ chiến lược giữa kiến trúc ứng dụng, yêu cầu hiệu năng và ràng buộc vận hành.
Mở rộng ngang hữu ích khi có thể phân phối công việc và quản lý các phụ thuộc; khả năng tăng trưởng và dự phòng vẫn hữu hạn và cần thiết kế. Mở rộng dọc có thể đơn giản hóa một số triển khai, nhưng lợi ích độ trễ, chi phí và quản lý trạng thái phải được đo theo ứng dụng.
So sánh chi phí trong cùng thời hạn, yêu cầu độ bền và mức dịch vụ. Cả hai cách có thể kết hợp autoscaling nơi được hỗ trợ; cần đo năng lực, thời gian điều chỉnh và hóa đơn thay vì suy ra một bên luôn có TCO tốt hơn.
Kubernetes, dịch vụ dự đoán và serverless có thể hỗ trợ một số chiến lược kết hợp khi được cấu hình đúng. Chúng không tự giải quyết giới hạn dữ liệu, quota hoặc yêu cầu vận hành của ứng dụng.
Một nhóm có thể bắt đầu với ít nút để đơn giản vận hành, rồi tăng tài nguyên hoặc thêm bản sao khi số đo cho thấy cần thay đổi. Không có lộ trình bắt buộc từ vertical sang horizontal rồi hybrid cho mọi startup; giữ khả năng điều chỉnh và rollback theo nhu cầu thực.
Nghiên cứu lượng tử, lập lịch carbon-aware và phần cứng dị thể bổ sung các hướng đánh giá, nhưng không thay thế việc hiểu tải, đo hệ thống và lập kế hoạch vận hành. Chọn công nghệ đã đáp ứng yêu cầu và bằng chứng kiểm thử của dự án.
Những triển khai mở rộng thành công nhất là nơi năng lực kỹ thuật phù hợp với mục tiêu kinh doanh, tạo ra hạ tầng hỗ trợ tăng trưởng đồng thời duy trì hiệu năng, độ tin cậy và hiệu quả chi phí.
Áp dụng cho dự án tại Việt Nam
Đo tải đại diện trước khi thay kiến trúc: thông lượng, độ trễ p95/p99, tỷ lệ lỗi, hàng đợi, tài nguyên và năng lực của cơ sở dữ liệu. So sánh một nút lớn hơn với nhiều bản sao ở cùng mức độ bền, dự phòng và tổng chi phí; dùng đơn vị tiền tệ thống nhất, tính cả lưu trữ, truyền dữ liệu, giấy phép và nhân sự. Tăng năng lực từng bước, thử lỗi nút và phục hồi dữ liệu trong môi trường thử nghiệm, rồi đặt giới hạn chi phí và kế hoạch rollback phù hợp.
Tài liệu kỹ thuật đối chiếu
- Kubernetes: Horizontal Pod Autoscaling
- Kubernetes: Vertical Pod Autoscaling
- Kubernetes: lập lịch pod lên node
- AWS: đổi loại EC2 instance
- AWS: quota Lambda
- Google Spanner: giao dịch và nhất quán ngoài
- Google: carbon-aware computing theo vị trí
- IBM: qubit và giới hạn truyền thông tin
- NIST: thông tin lượng tử không truyền nhanh hơn ánh sáng
Câu hỏi thường gặp
Sự khác biệt chính giữa mở rộng theo chiều ngang và theo chiều dọc là gì?
Mở rộng ngang tăng số nút hoặc bản sao để chia tải; mở rộng dọc tăng CPU, RAM, I/O hoặc tài nguyên cho một nút. Cả hai đều hữu hạn và phụ thuộc khả năng ứng dụng sử dụng tài nguyên. Nhiều nút không tự có dự phòng, còn ít nút không mặc định nhanh hơn.
Cách mở rộng nào tiết kiệm chi phí hơn?
Không có bên tiết kiệm hơn trong mọi trường hợp. So sánh TCO cùng thời hạn, mức dịch vụ và dự phòng, gồm thiết bị hoặc phí thuê, giấy phép, điện, mạng, dữ liệu và vận hành. Autoscaling có thể giảm năng lực nhàn rỗi khi tải phù hợp nhưng cũng có chi phí và điều kiện triển khai.
Làm sao tôi biết chiến lược mở rộng nào phù hợp với ứng dụng của mình?
Đo nút thắt, trạng thái dữ liệu, độ trễ, thông lượng và tải cao điểm. Đánh giá khả năng chia công việc, giới hạn cấu hình, quota, thời gian khởi động, kỹ năng vận hành và kế hoạch phục hồi. Có thể kết hợp hai cách, thay vì chọn chỉ dựa trên việc ứng dụng có trạng thái hay đường tăng trưởng.
Kubernetes có tự động xử lý cả mở rộng ngang và dọc không?
Kubernetes có HPA để điều chỉnh số bản sao theo metrics đã cấu hình; cần nguồn chỉ số phù hợp. VPA là thành phần cài riêng để khuyến nghị hoặc điều chỉnh requests và limits theo cấu hình. Khi kết hợp phải kiểm tra tương tác chỉ số, tài nguyên node và cách cập nhật pod; không mặc định mọi cụm tự mở rộng cả hai lớp.
Kiến trúc cơ sở dữ liệu đóng vai trò gì trong quyết định mở rộng?
Dữ liệu có thể là giới hạn của cả hai cách. Scale up không tự làm truy vấn nhanh hơn; scale out có thể dùng read replica hoặc sharding cho các mục tiêu khác nhau và có thể tăng chi phí phối hợp. Cơ sở dữ liệu phân tán vẫn có thể hỗ trợ ACID/nhất quán mạnh; cần chọn theo giao dịch, mức cô lập, mô hình truy vấn và phần mềm thực tế.
Ứng dụng thực tế với STALI
Với chủ đề Mở rộng ngang và dọc, hãy thử trên dữ liệu và tiêu chí thành công của chính bạn, gồm độ chính xác, độ trễ và tổng chi phí. Với dữ liệu tiếng Việt, nên thử thêm cách diễn đạt địa phương, tài liệu dài và yêu cầu định dạng đầu ra. Lưu lại cấu hình và kết quả để so sánh các phương án bằng cùng một phép thử.
Kiểm tra mô hình đang được hỗ trợ và mức phí hiện hành tại bảng giá STALI. Giá nhà cung cấp được phân tích trong bài là dữ kiện tham khảo, không thay thế giá bán và điều kiện sử dụng trên STALI.
Để triển khai, đọc tài liệu tích hợp API STALI, sau đó đăng ký tài khoản STALI để quản lý khóa API và sử dụng các mô hình có trong danh mục.
Đọc thêm các phân tích liên quan trên STALI: