Bức tranh kiến trúc dữ liệu đang thay đổi dưới tác động của việc sử dụng công nghệ đám mây ngày càng tăng và sự phổ biến của modern data stack. Do đó, quy trình ELT ngày càng được áp dụng rộng rãi. Nhưng chính xác thì quy trình này bao gồm những gì?
Trong bài viết này, chúng ta sẽ tìm hiểu về ELT và vai trò của nó trong kiến trúc dữ liệu tiên tiến.
ELT là gì?
ELT là viết tắt của Extract, Load, Transform (Trích xuất, Nạp, Chuyển đổi). Đây là một quy trình tích hợp dữ liệu, bao gồm việc trích xuất dữ liệu từ nhiều nguồn, nạp vào hệ thống lưu trữ dữ liệu và chuyển đổi thành định dạng dễ phân tích.
Quy trình ELT chủ yếu được sử dụng trong kiến trúc modern data stack, nơi dữ liệu được lưu trữ, chuyển đổi và phân tích trong data lake hoặc data warehouse.
ELT hoạt động như thế nào?
Đúng như tên gọi, ELT bao gồm ba bước chính: Extract, Load và Transform. Hãy cùng xem kỹ từng bước.
1. Extract
Bước đầu tiên trong quy trình ELT là trích xuất dữ liệu từ nhiều nguồn như cơ sở dữ liệu, tệp, API hoặc dịch vụ web. Việc này có thể được thực hiện bằng các công cụ ELT hoặc các script tùy chỉnh do nhà phát triển viết.
Một số nền tảng trích xuất dữ liệu phổ biến gồm Airbyte và Fivetran. Để viết script tùy chỉnh, Apache Spark và Python được sử dụng rộng rãi.
Dữ liệu được trích xuất có thể là dữ liệu có cấu trúc, bán cấu trúc hoặc phi cấu trúc và có thể đến từ nhiều hệ thống khác nhau, như cơ sở dữ liệu quan hệ, cơ sở dữ liệu NoSQL hoặc lưu trữ đám mây.
2. Load
Sau khi dữ liệu được trích xuất, dữ liệu sẽ được nạp vào hệ thống lưu trữ dữ liệu tập trung như data lake hoặc data warehouse. Bước này liên quan đến việc tổ chức và lưu trữ dữ liệu đã trích xuất ở dạng thô, chưa qua chuyển đổi.
Các kỹ sư dữ liệu thường tham gia bước này, nơi họ nạp dữ liệu lên các nền tảng như:
- AWS S3
- Google BigQuery
- Snowflake
- Amazon Redshift
Các nền tảng này tập trung dữ liệu từ nhiều nguồn; chất lượng và tính nhất quán vẫn cần được kiểm soát trong pipeline.
3. Transform
Bước cuối cùng trong quy trình ELT là chuyển đổi dữ liệu thô thành định dạng tối ưu cho phân tích và báo cáo. Việc này bao gồm làm sạch, lọc, tổng hợp và cấu trúc dữ liệu theo cách phù hợp để các công cụ BI và phân tích có thể sử dụng.
Kỹ sư dữ liệu hoặc nhà khoa học dữ liệu thường chịu trách nhiệm bước này, họ có thể sử dụng các công cụ như:
- Câu lệnh SQL
- Apache Spark
- Các thư viện Python như Pandas hoặc NumPy
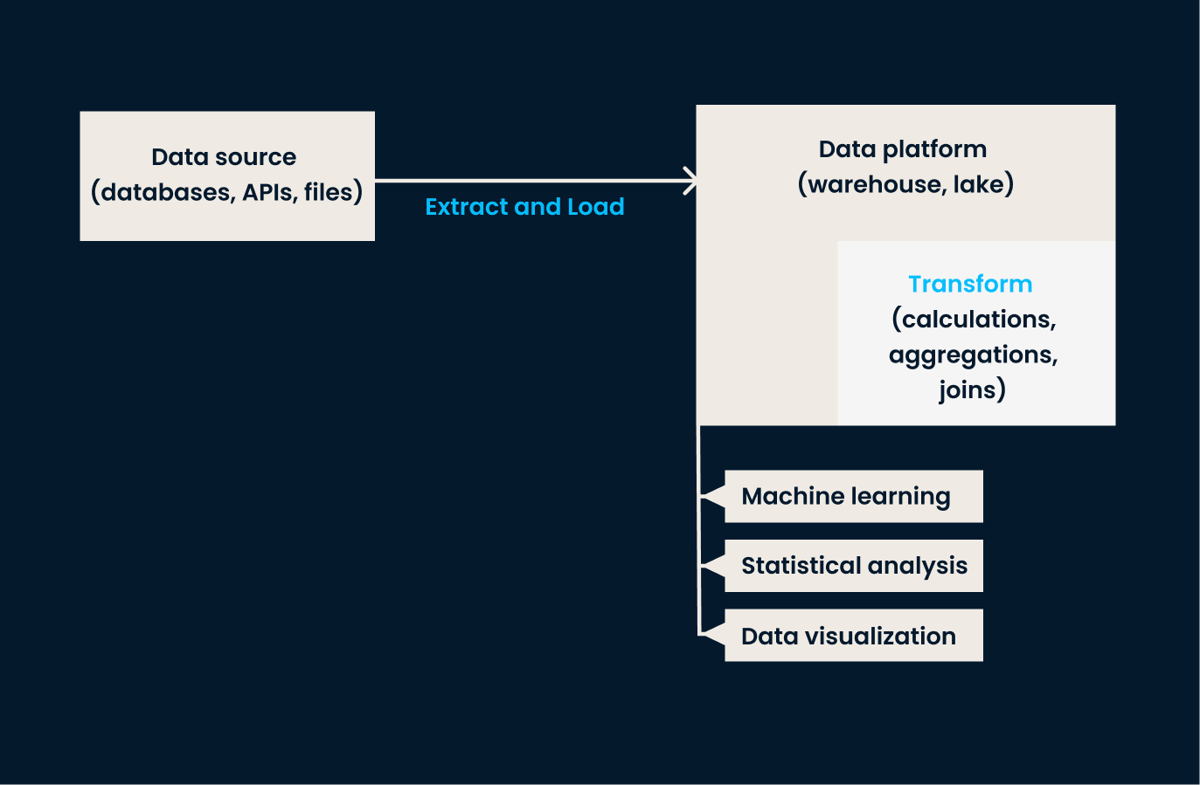
Pipeline dữ liệu ELT: Các giai đoạn trích xuất và nạp diễn ra trước khi bất kỳ chuyển đổi nào được áp dụng lên dữ liệu. Bước chuyển đổi được thực hiện trong chính nền tảng dữ liệu.
Việc chuyển đổi dữ liệu được thực hiện trong data warehouse hoặc data lake, giúp xử lý khối lượng dữ liệu lớn dễ dàng hơn. Với các công nghệ đám mây hiện đại, quy trình này có thể diễn ra gần thời gian thực, giúp tổ chức truy cập dữ liệu mới và chính xác để phân tích.
Ưu điểm của ELT
ELT có nhiều lợi ích, dưới đây là một số điểm nổi bật:
- Khả năng mở rộng: ELT tận dụng năng lực xử lý của nền tảng dữ liệu để mở rộng khối lượng trích xuất, nạp và chuyển đổi; lợi ích phụ thuộc vào tài nguyên hệ thống đích.
- Tính linh hoạt: ELT cho phép tích hợp dữ liệu từ nhiều nguồn, bao gồm dữ liệu có cấu trúc, bán cấu trúc và phi cấu trúc.
- Độ trễ dữ liệu: Có thể chuyển đổi dữ liệu theo nhu cầu hoặc gần thời gian thực khi kiến trúc tiếp nhận và xử lý phù hợp; ELT không tự bảo đảm độ trễ thấp.
ELT so với ETL
Giờ hãy so sánh sự khác biệt giữa ELT và ETL.
Như đã đề cập, ELT là cách tiếp cận mới trong xử lý dữ liệu, trong đó dữ liệu được nạp trước vào kho trung tâm, cho phép thực hiện chuyển đổi sau khi nạp.
Ngược lại, ETL (Extract, Transform, Load) là phương pháp truyền thống, trong đó dữ liệu được chuyển đổi trước khi nạp vào hệ thống đích. Những khác biệt cốt lõi này ảnh hưởng không chỉ đến quy trình mà còn đến tốc độ, chi phí và bảo mật.
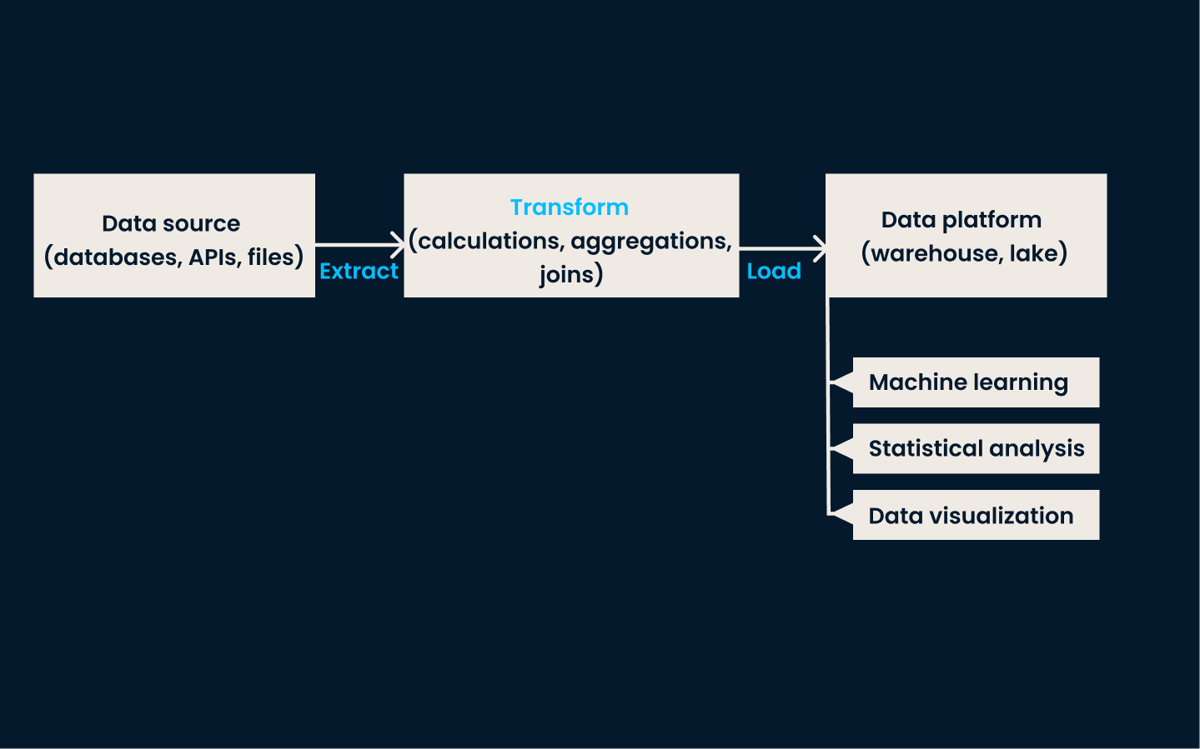
Pipeline ETL: Bước chuyển đổi diễn ra trước khi nạp dữ liệu lên nền tảng đích. Thông thường, chuyển đổi diễn ra trên máy chủ tách biệt thay vì trong chính nền tảng dữ liệu.
Quy trình
ELT tuân theo cách làm “nạp trước, chuyển đổi sau”, trong đó dữ liệu được nạp vào hệ thống lưu trữ ở dạng thô rồi mới chuyển đổi để phân tích.
Trong khi đó, ETL theo hướng “trích xuất - chuyển đổi - nạp”, tức dữ liệu được trích xuất từ nhiều nguồn, sau đó chuyển đổi và cuối cùng nạp vào data warehouse.
Tốc độ
ELT có thể rút ngắn thời gian đưa dữ liệu thô vào nền tảng đích vì chuyển đổi diễn ra sau khi nạp. Hiệu năng phân tích còn phụ thuộc vào tài nguyên và cách tổ chức tác vụ.
ETL chuyển đổi trước khi nạp; các giai đoạn vẫn có thể được tổ chức chạy song song. Vì vậy cần đo trên tải thực tế thay vì mặc định ELT luôn nhanh hơn.
Chi phí
ELT có thể giảm số hệ thống chuyển đổi riêng bằng cách dùng SQL và công cụ trên nền tảng đích; vẫn phát sinh chi phí lưu trữ, tính toán và vận hành.
ETL được triển khai trên cả hạ tầng tại chỗ và đám mây. So sánh tổng chi phí theo khối lượng dữ liệu, tần suất chạy và cấu hình thực tế.
Bảo mật
ELT có thể sử dụng tính năng mã hóa, phân quyền và che giấu PII của nền tảng đích. Các biện pháp này cần được cấu hình; việc nạp dữ liệu thô không tự làm dữ liệu an toàn.
Cả ETL và ELT đều cần bảo vệ dữ liệu xuyên suốt quá trình trích xuất, lưu trữ và chuyển đổi. Nếu kiến trúc có máy chủ hoặc vùng lưu trữ trung gian, các thành phần đó cũng cần được bảo vệ.
Trường hợp sử dụng ELT
ELT phù hợp với nhiều tác vụ phân tích trên nền tảng có đủ năng lực chuyển đổi; lựa chọn ELT hay ETL phụ thuộc vào yêu cầu cụ thể.
Dưới đây là một số cách sử dụng phổ biến của ELT:
- Báo cáo độ trễ thấp cho ứng dụng: Kết hợp tiếp nhận liên tục và xử lý phù hợp có thể hỗ trợ báo cáo gần thời gian thực về hành vi người dùng.
- Kho dữ liệu: Nhiều tổ chức dùng ELT để nạp và chuyển đổi dữ liệu vào kho dữ liệu tập trung nhằm phục vụ báo cáo và phân tích.
- Tích hợp dữ liệu trên đám mây: Với sự trỗi dậy của công nghệ đám mây, ELT trở thành lựa chọn phổ biến để tích hợp nguồn dữ liệu từ nhiều ứng dụng on-premises và đám mây.
Công cụ và công nghệ ELT
Có nhiều công cụ và công nghệ để tổ chức triển khai quy trình ELT. Bao gồm:
Data warehouse và data lake
Trong bước nạp của quy trình ELT, data lake và data warehouse đóng vai trò thiết yếu, cung cấp không gian lưu trữ dữ liệu tập trung trong doanh nghiệp.
Dưới đây là các nền tảng dữ liệu đám mây phổ biến nhất:
- Amazon Redshift: Dịch vụ kho dữ liệu đám mây có thể xử lý lượng dữ liệu khổng lồ nhanh chóng và hiệu quả.
- Google BigQuery: Kho dữ liệu đám mây không máy chủ, có khả năng mở rộng, cho phép truy vấn nhanh các bộ dữ liệu lớn.
- Snowflake: Kho dữ liệu dựa trên đám mây hỗ trợ quy trình ELT và cung cấp bảo mật, hiệu năng nâng cao.
- Amazon S3: Lưu trữ đối tượng có thể làm nền tảng data lake cho dữ liệu thô; việc chuyển đổi được thực hiện qua công cụ xử lý kết nối với dữ liệu đó.
Công cụ hỗ trợ quy trình ELT
Tổ chức có thể kết hợp các công cụ mã nguồn mở và các sản phẩm tự triển khai hoặc dịch vụ; cần xem giấy phép và phạm vi từng phiên bản.
Các công cụ này có thể hỗ trợ những giai đoạn khác nhau của quy trình ELT:
- Apache Airflow: Dùng để tự động hóa luồng công việc và lập lịch các quy trình ETL/ELT.
- dbt: Công cụ chuyển đổi dữ liệu trong nền tảng phân tích bằng SQL; tham khảo tài liệu hiện hành cho từng phiên bản và cách triển khai.
- Airbyte: Nền tảng tích hợp dữ liệu hỗ trợ ELT và ETL. Kho mã hiện hành có giấy phép Elastic License 2.0; cần xem điều khoản của thành phần sử dụng.
- Singer: Công cụ mã nguồn mở được dùng trong cả ELT và ETL theo cách tiếp cận mô-đun.
- Apache NiFi: Công cụ tích hợp dữ liệu mã nguồn mở hỗ trợ định tuyến dữ liệu, chuyển đổi và logic trung gian hệ thống.
Các công cụ này mang lại nhiều lựa chọn tích hợp và tùy biến. Khả năng, hình thức triển khai và điều khoản sử dụng khác nhau giữa từng công cụ.
Script tự xây dựng
Các nhà phát triển cũng có thể sử dụng các script viết bằng ngôn ngữ lập trình để tăng khả năng tùy biến. Cách này thường sử dụng các package và thư viện để xử lý và chuyển đổi dữ liệu.
Một số ngôn ngữ lập trình và framework có thể dùng trong các script này gồm:
- Python: Sử dụng các thư viện như Pandas, NumPy và SQLAlchemy có thể hỗ trợ trích xuất, nạp và chuyển đổi dữ liệu.
- Apache Spark: Dùng để xử lý và phân tích dữ liệu lớn, thường tận dụng các ngôn ngữ như Python (PySpark), Java và Scala.
- R: Khung tidyverse cùng các thư viện R khác như dplyr và data.table có thể được dùng để trích xuất và chuyển đổi dữ liệu.
- SQL: Câu lệnh SQL có thể dùng cho các tác vụ chuyển đổi, và SQL Server Integration Services (SSIS) là công cụ ETL phổ biến cũng hỗ trợ quy trình ELT.
- Scala: Thường dùng với Apache Spark cho xử lý dữ liệu lớn và tác vụ ELT.
- Java: Thường dùng với các framework dữ liệu lớn như Apache Hadoop và Apache Spark cho quy trình ELT.
Tổng kết
ELT là một cách tiếp cận phổ biến cho tích hợp dữ liệu trong kiến trúc đám mây: nạp dữ liệu trước, rồi chuyển đổi tại nền tảng đích. Tính linh hoạt và khả năng mở rộng là lợi thế khi thiết kế phù hợp; hiệu năng, chi phí và bảo mật cần được đánh giá trên hệ thống thực tế.
Đối chiếu kỹ thuật: Microsoft về ETL, ELT và streaming; AWS về thứ tự xử lý và các đánh đổi; tài liệu dbt; giấy phép trong kho Airbyte.
Câu hỏi thường gặp
ELT xử lý các vấn đề về chất lượng và tính nhất quán dữ liệu như thế nào?
ELT xử lý chất lượng và tính nhất quán dữ liệu bằng cách tận dụng khả năng của data warehouse hoặc data lake nơi dữ liệu được lưu trữ. Các bước kiểm tra chất lượng, làm sạch và xác thực dữ liệu được áp dụng trong giai đoạn chuyển đổi để đảm bảo tính nhất quán và độ chính xác. Các công cụ như dbt (data build tool) có thể được dùng để tạo pipeline chuyển đổi bao gồm các kiểm tra chất lượng này, giúp duy trì tiêu chuẩn cao về tính toàn vẹn dữ liệu.
ELT có thể được dùng cho streaming dữ liệu thời gian thực không và nếu có thì như thế nào?
Có thể kết hợp Kafka hoặc Kinesis để tiếp nhận liên tục, rồi chuyển đổi bằng Spark hoặc SQL. Tuy nhiên, streaming và ELT theo lô là các cách tổ chức xử lý khác nhau; cần chọn kiến trúc theo độ trễ yêu cầu.
ELT tích hợp với quy trình học máy như thế nào?
ELT tích hợp với quy trình học máy bằng cách cung cấp pipeline dữ liệu vững chắc để đưa dữ liệu sạch, đã chuyển đổi vào các mô hình học máy. Sau khi dữ liệu được nạp vào data warehouse, dữ liệu có thể được chuyển đổi và chuẩn bị cho học máy bằng các công cụ như Apache Spark MLlib hoặc các thư viện Python như scikit-learn. Sự tích hợp này cho phép tiền xử lý dữ liệu, huấn luyện và đánh giá mô hình diễn ra liền mạch trong cùng môi trường, nâng cao hiệu quả và khả năng mở rộng.
Những lưu ý bảo mật nào khi triển khai ELT trong môi trường đám mây?
Khi triển khai ELT trong môi trường đám mây, các cân nhắc về bảo mật bao gồm mã hóa dữ liệu, kiểm soát truy cập và che giấu dữ liệu. Dữ liệu cần được mã hóa khi truyền và khi lưu trữ để bảo vệ thông tin nhạy cảm. Cơ chế kiểm soát truy cập, như RBAC (kiểm soát truy cập dựa trên vai trò), nên được áp dụng để đảm bảo chỉ người được ủy quyền mới có thể truy cập và thao tác dữ liệu. Các kỹ thuật che giấu dữ liệu có thể áp dụng để bảo vệ dữ liệu nhận dạng cá nhân (PII) trong quá trình nạp và chuyển đổi.
Các kỹ sư dữ liệu xử lý thách thức tiến hóa lược đồ trong quy trình ELT như thế nào?
Các chuyên gia dữ liệu xử lý tiến hóa lược đồ (schema evolution) trong quy trình ELT bằng các công cụ và thực hành quản lý lược đồ để thích ứng với thay đổi theo thời gian. Điều này bao gồm sử dụng Apache Avro cho dữ liệu có lược đồ, và JSON Schema để định nghĩa, xác thực cấu trúc dữ liệu JSON. Ngoài ra, có thể áp dụng chiến lược phiên bản hóa và script di chuyển lược đồ tự động để quản lý thay đổi nhằm hạn chế gián đoạn pipeline dữ liệu. Các công cụ danh mục dữ liệu và quản lý siêu dữ liệu cũng đóng vai trò quan trọng trong việc theo dõi và ghi nhận thay đổi lược đồ để đảm bảo tính nhất quán và độ tin cậy của dữ liệu.
Xem giải thích chính thức về JSON Schema.
Ứng dụng thực tế với STALI
Với chủ đề ELT là gì? Quy trình, công cụ và cách lựa chọn so với ETL, hãy thử trên dữ liệu và tiêu chí thành công của chính bạn, gồm độ chính xác, độ trễ và tổng chi phí. Với dữ liệu tiếng Việt, nên thử thêm cách diễn đạt địa phương, tài liệu dài và yêu cầu định dạng đầu ra. Lưu lại cấu hình và kết quả để so sánh các phương án bằng cùng một phép thử.
Kiểm tra mô hình đang được hỗ trợ và mức phí hiện hành tại bảng giá STALI. Giá nhà cung cấp được phân tích trong bài là dữ kiện tham khảo, không thay thế giá bán và điều kiện sử dụng trên STALI.
Để triển khai, đọc tài liệu tích hợp API STALI, sau đó đăng ký tài khoản STALI để quản lý khóa API và sử dụng các mô hình có trong danh mục.
Đọc thêm các phân tích liên quan trên STALI: